Une archive nommée extension-interne-v-finale-2.zip, transmise par e-mail lors du départ du dernier développeur qui la maintenait : voilà le point de départ typique d’une reprise de code sans aucun historique de versions. Le fichier readme.txt mentionne une dernière modification, sans plus de détail. Aucun dépôt Git, aucun changelog structuré, aucune trace de qui a modifié quoi ni pourquoi. Et pourtant cette extension gère une fonctionnalité métier critique, qu’il faudra continuer à faire évoluer.
Cette checklist décrit la méthode pour reconstruire un dépôt exploitable à partir de ces seules métadonnées de fichiers, sans prétendre recréer un historique de commits authentique. Elle ne traite pas de la refonte du code de l’extension elle-même, qui viendra dans un second temps, une fois cette base d’historique posée.
Pourquoi reconstruire un historique a de la valeur, même approximatif
Un dépôt Git vide, initialisé avec un simple git init suivi d’un unique commit contenant tout le code d’un coup, prive l’équipe de toute possibilité de comprendre l’évolution du projet : quelle fonctionnalité a été ajoutée à quelle période, quel fichier a été modifié récemment et lequel n’a pas bougé depuis des années. Reconstruire, même approximativement, une chronologie à partir des métadonnées disponibles redonne un minimum de contexte, utile notamment pour prioriser les zones du code les plus récentes et donc potentiellement les moins stabilisées.
Étape 1 : extraire les métadonnées de date de chaque fichier
La première question à se poser : l’archive zip elle-même contient-elle des horodatages fiables par fichier, ou a-t-elle été recréée après coup, ce qui aurait réinitialisé toutes les dates à l’instant de la compression ? La commande suivante liste les fichiers avec leur date de modification telle qu’enregistrée dans l’archive :
unzip -l extension-interne-v-finale-2.zip
Si les dates affichées varient d’un fichier à l’autre, l’archive a conservé les métadonnées d’origine du système de fichiers, et l’exercice de reconstruction a du sens. Si toutes les dates sont identiques, à quelques secondes près, l’archive a probablement été recréée d’un bloc, et il faut alors chercher une autre source, comme une sauvegarde de serveur plus ancienne contenant encore les vraies dates.
Étape 2 : regrouper les fichiers par date et reconstituer des commits successifs
Une fois les dates confirmées fiables, l’idée consiste à regrouper les fichiers par proximité temporelle (même jour, ou même semaine selon la densité des modifications) et à créer un commit Git par groupe, avec une date forcée correspondant à celle des fichiers concernés :
- Extraire l’archive dans un dossier de travail temporaire, hors de tout dépôt Git existant.
- Lister l’ensemble des fichiers triés par date de modification croissante, à l’aide d’un script qui interroge le système de fichiers plutôt que l’archive elle-même une fois extraite.
- Initialiser un dépôt Git vide dans un nouveau dossier destiné à devenir le futur dépôt de travail.
- Copier les fichiers groupe par groupe, du plus ancien au plus récent, en créant un commit après chaque groupe.
- Forcer la date de chaque commit avec les variables d’environnement dédiées, pour que l’historique Git reflète la chronologie réelle plutôt que la date du jour de la reconstruction.
GIT_AUTHOR_DATE="2022-03-14T10:00:00" \
GIT_COMMITTER_DATE="2022-03-14T10:00:00" \
git commit -m "Reconstruction : fichiers modifiés vers mars 2022"
Étape 3 : documenter les limites de cette reconstruction
Un historique reconstruit de cette façon reste une approximation, pas un historique authentique. Il ne faut jamais laisser croire à l’équipe future qu’il s’agit de vrais commits d’origine. Un fichier HISTORIQUE_RECONSTRUCTION.md, ajouté à la racine du dépôt, doit expliquer clairement la méthode utilisée, la source des métadonnées, et la date à laquelle la reconstruction a été effectuée.
Étape 4 : vérifier la cohérence fonctionnelle avant de considérer le dépôt fiable
Reconstruire un historique chronologique ne garantit pas que le code lui-même fonctionne encore correctement. Il reste indispensable d’installer l’extension sur un environnement de test isolé et de vérifier ses fonctionnalités principales avant de la considérer comme une base saine pour de futures évolutions.
| Élément vérifié | Pourquoi c’est important |
|---|---|
| Dates fiables dans l’archive | Condition préalable à toute reconstruction |
| Regroupement chronologique cohérent | Évite un historique artificiellement linéaire et trompeur |
| Documentation de la méthode | Empêche toute confusion future avec un historique réel |
| Test fonctionnel post-reconstruction | Valide que le code repris est réellement exploitable |
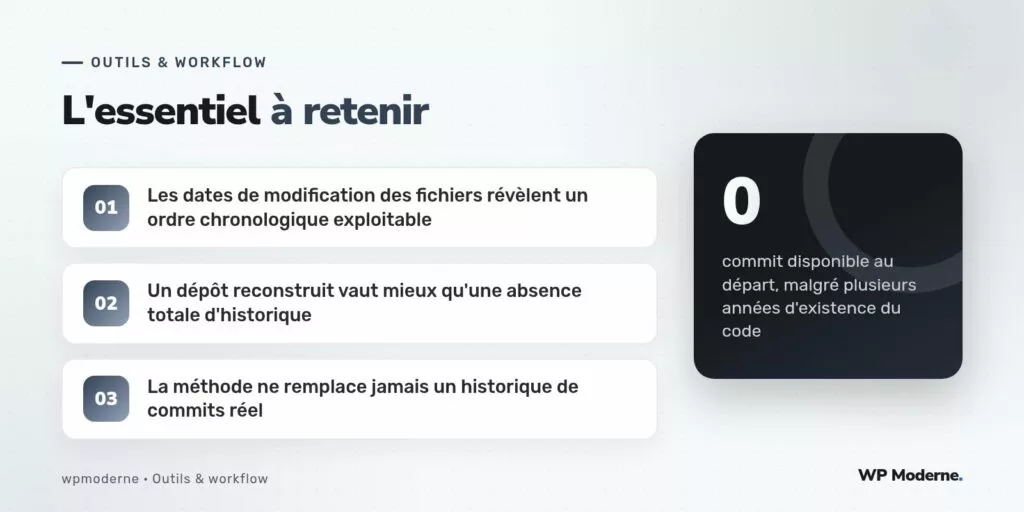
Une règle que nous appliquons systématiquement sur ce genre de reprise : ne jamais présenter un historique reconstruit comme équivalent à un historique de commits réel, même une fois la chronologie remise en ordre.
En résumé
Reconstruire l’historique d’une extension livrée sans aucun versionnage ne recrée jamais la richesse d’un vrai suivi de commits, mais transforme un bloc de code opaque en une chronologie exploitable, suffisante pour prioriser les zones les plus récentes et documenter honnêtement les limites de la démarche pour l’équipe qui reprendra ce code après vous.