Avant la refonte décrite ici, chaque nouveau client de l’agence recevait son propre fichier de workflow GitHub Actions, copié depuis le client précédent puis ajusté à la main : nom du serveur, méthode de déploiement, présence ou non d’un build front, etc. Après trois ans, l’agence gérait quarante variantes légèrement différentes du même pipeline, chacune ayant dérivé indépendamment au fil des correctifs appliqués ponctuellement. Corriger un bug de déploiement demandait, dans le pire des cas, de le corriger quarante fois.
Ce texte ne revient pas sur le déploiement blue-green en tant que technique, déjà détaillé séparément. Il décrit l’architecture retenue pour unifier ces quarante pipelines en un seul, paramétré, sans perdre la capacité à gérer les spécificités de chaque client.
Identifier ce qui varie réellement d’un site à l’autre
Un audit des quarante workflows existants a permis de classer les variations en quatre catégories : la méthode de transport du code (rsync, SFTP, ou déploiement via image Docker), la présence ou non d’un build front nécessitant Node, l’hébergeur cible avec ses particularités de connexion, et une poignée de cas vraiment singuliers, comme un client avec une étape de purge de cache CDN spécifique à son fournisseur.
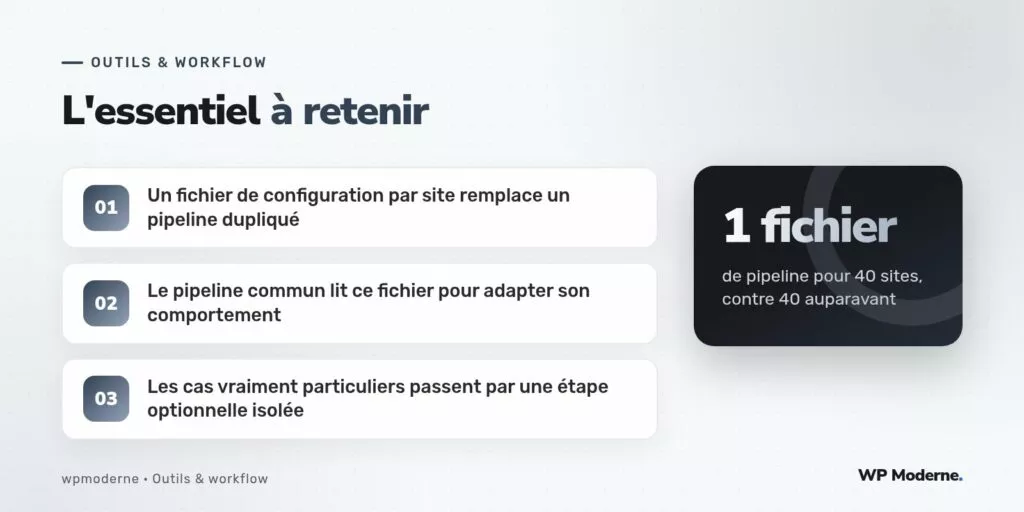
Un fichier de configuration par site
Chaque dépôt de site reçoit désormais un fichier deploiement.yaml à sa racine, qui décrit ses propres particularités sans jamais toucher au pipeline lui-même :
# deploiement.yaml
site:
  nom: boutique-nord
  methode_transport: rsync
  hote: boutique-nord.example.com
  utilisateur_ssh: deploiement
  chemin_distant: /var/www/boutique-nord

build:
  front_active: true
  gestionnaire: npm
  commande: "npm ci && npm run build"

etapes_supplementaires:
  - purge_cache_cloudflare

apres_deploiement:
  wp_cli:
    - "cache flush"
    - "rewrite flush"
Le pipeline commun qui lit cette configuration
Un unique fichier .github/workflows/deploiement.yml, versionné dans un dépôt central puis référencé comme workflow réutilisable par chaque dépôt client, lit ce fichier de configuration et adapte son comportement en conséquence :
jobs:
  deployer:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      - name: Lire la configuration du site
        id: config
        run: |
          echo "methode=$(yq '.site.methode_transport' deploiement.yaml)" >> "$GITHUB_OUTPUT"
          echo "front_active=$(yq '.build.front_active' deploiement.yaml)" >> "$GITHUB_OUTPUT"
          echo "hote=$(yq '.site.hote' deploiement.yaml)" >> "$GITHUB_OUTPUT"

      - name: Construire le front si nécessaire
        if: steps.config.outputs.front_active == 'true'
        run: |
          COMMANDE=$(yq '.build.commande' deploiement.yaml)
          eval "$COMMANDE"

      - name: Déployer via rsync
        if: steps.config.outputs.methode == 'rsync'
        run: |
          rsync -avz --delete ./ deploiement@${{ steps.config.outputs.hote }}:$(yq '.site.chemin_distant' deploiement.yaml)

      - name: Déployer via SFTP
        if: steps.config.outputs.methode == 'sftp'
        run: |
          lftp -c "open -u deploiement, sftp://${{ steps.config.outputs.hote }}; mirror -R ./ ."

      - name: Exécuter les commandes WP-CLI post-déploiement
        run: |
          yq '.apres_deploiement.wp_cli[]' deploiement.yaml | while read -r commande; do
            ssh deploiement@${{ steps.config.outputs.hote }} "wp $commande --allow-root"
          done
Gérer les étapes vraiment particulières
Pour le client dont le CDN nécessite une purge spécifique, l’étape etapes_supplementaires déclenche un script dédié, isolé dans un dossier etapes-optionnelles/ du dépôt central, plutôt que d’introduire une branche conditionnelle spécifique dans le pipeline principal :
      - name: Exécuter les étapes supplémentaires
        run: |
          yq '.etapes_supplementaires[]' deploiement.yaml | while read -r etape; do
            bash "etapes-optionnelles/${etape}.sh"
          done
Ce que cette refonte a changé
| Avant | Après |
|---|---|
| 40 fichiers de workflow distincts | 1 fichier de workflow réutilisable |
| Correctif appliqué site par site | Correctif appliqué une fois, propagé à tous |
| Nouveau client : copier-coller et adapter | Nouveau client : remplir un fichier YAML |
| Dérive silencieuse entre pipelines | Comportement identique garanti par construction |
La limite de cette approche
Cette unification demande une discipline de conception stricte : chaque nouveau besoin client doit d’abord être analysé pour déterminer s’il s’agit d’une variation légitime à paramétrer proprement, ou d’un cas si singulier qu’il justifie de rester une étape optionnelle isolée plutôt que d’ajouter une nouvelle branche conditionnelle générale dans le pipeline commun. Céder à la facilité d’ajouter une condition if supplémentaire à chaque demande finirait par reconstituer, à terme, la même complexité dispersée que celle qu’on cherchait à éliminer.
Un pipeline commun qui accumule les cas particuliers non maîtrisés finit toujours par redevenir quarante pipelines déguisés en un seul.
En résumé
Le passage à un pipeline unique paramétrable a réduit drastiquement le coût de maintenance du parc de déploiements de l’agence, au prix d’un effort de conception initial pour bien distinguer ce qui relève d’un paramètre légitime de ce qui relève d’une véritable exception. Le fichier de configuration par site, simple et lisible même par un développeur qui découvre le projet, s’est révélé être le bon niveau d’abstraction pour ce parc particulier.