Début 2025, avec la maturation des serveurs MCP pour WordPress, nous avons testé, sur le blog interne de notre propre agence, un agent autonome capable d’enchaîner de bout en bout la recherche d’un sujet, la rédaction d’un article et sa publication directe, sans validation humaine intermédiaire. L’objectif du test était volontairement poussé au bout de la logique d’autonomie, pour en mesurer concrètement les risques réels avant d’envisager quoi que ce soit chez un client.
L’agent, connecté à un serveur MCP exposant les outils de création et de publication d’articles, recevait chaque matin une consigne générale (« publie un article sur une actualité récente du développement web »), cherchait une source d’information via un outil de recherche, rédigeait un texte, et le publiait directement en statut publié, sans aucune étape intermédiaire de relecture.
Ce qui a bien fonctionné les premiers jours
Sur la première semaine de test, l’agent a publié cinq articles de qualité rédactionnelle correcte, sur des sujets d’actualité technique réels, avec un enchaînement fluide entre la recherche de la source et la rédaction. Rien ne laissait présager de problème imminent, ce qui, avec le recul, constitue précisément le piège de ce genre de test : la réussite initiale renforce une confiance qui se révèle ensuite mal placée.
L’incident survenu le sixième jour
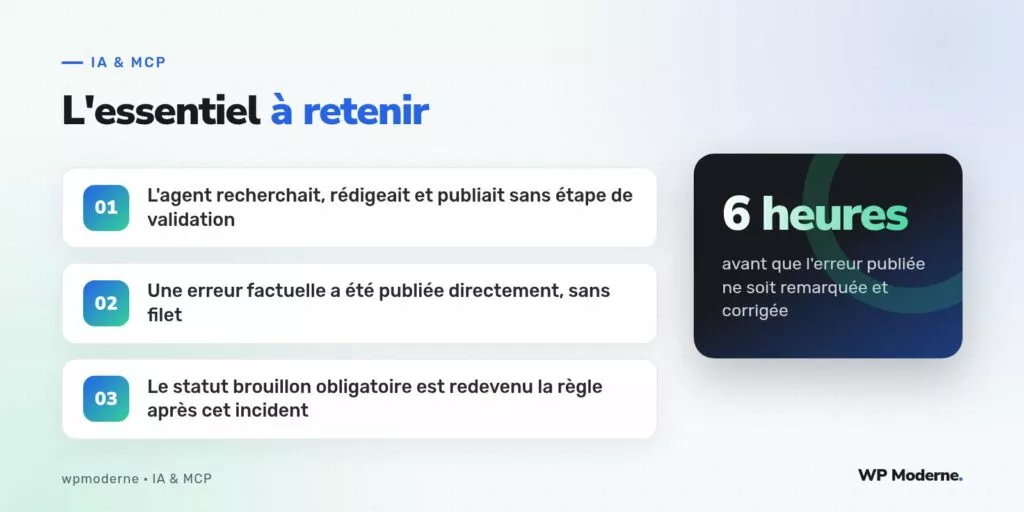
L’agent a rédigé un article annonçant, à tort, la disponibilité d’une fonctionnalité dans une version de WordPress qui n’était alors qu’en phase de test, en confondant une discussion de proposition sur le dépôt du projet avec une fonctionnalité réellement livrée. L’article a été publié directement, sans aucun contrôle intermédiaire, et est resté en ligne environ six heures avant qu’un membre de l’équipe, en consultant le blog par hasard, ne remarque l’erreur et ne le corrige manuellement.
Le diagnostic après coup
L’agent n’avait aucune méthode fiable pour distinguer une proposition en discussion d’une fonctionnalité réellement publiée, faute d’instruction explicite à ce sujet dans sa consigne initiale, trop générale. Le serveur MCP, de son côté, exposait un outil de publication directe sans distinction de statut intermédiaire, ce qui n’incitait pas l’agent à passer par une étape de validation avant la mise en ligne effective.
- Consigne de départ trop vague sur la nécessité de vérifier le statut réel d’une information technique
- Outil de publication exposé côté serveur MCP sans statut brouillon imposé par défaut
- Aucune alerte automatique en cas de publication en dehors des horaires de vérification humaine
Les garde-fous ajoutés depuis
Le principal changement a porté sur le serveur MCP lui-même, plutôt que sur l’agent : l’outil de publication d’article a été retiré de l’ensemble des capacités exposées, remplacé par un outil qui ne peut créer un article qu’en statut brouillon, quelle que soit la demande formulée par l’agent qui l’appelle. La bascule en statut publié reste une action manuelle, réalisée depuis l’interface d’administration par un membre de l’équipe.
// Extrait conceptuel de la définition de l'outil côté serveur MCP
// L'outil ne permet plus que la création en brouillon, jamais la publication directe
'creer_article' => array(
    'statut_force' => 'draft',
    'description'  => 'Crée un brouillon d\'article, ne le publie jamais directement.',
),
Une notification automatique a également été ajoutée, envoyée à l’équipe éditoriale à chaque nouveau brouillon créé par l’agent, avec un lien direct vers l’écran de relecture, pour que ces brouillons ne s’accumulent pas sans être traités.
Un agent qui réussit plusieurs fois de suite n’a rien prouvé sur sa fiabilité à long terme, il a seulement retardé le moment où son erreur allait devenir visible.
En résumé
Ce premier test d’un agent autonome bout en bout, mené sur notre propre blog plutôt que chez un client, a confirmé que le risque principal ne vient pas de la qualité rédactionnelle de l’agent, globalement correcte, mais de l’absence d’un filet de validation humaine avant publication effective. Depuis cet incident, tout outil de publication exposé à un agent, quel que soit le serveur MCP utilisé, impose désormais un statut brouillon strict, la décision de publier restant une action humaine délibérée.