Un client nous a demandé, il y a quelques semaines, de « connecter un agent IA » à son catalogue de fiches produits. Sa première idée : écrire un serveur MCP complet, avec ses outils, son schéma, son transport. Après discussion, il ne s’agissait en réalité que de lecture seule, à faible fréquence, pour alimenter un comparateur externe. Un serveur MCP aurait été une solution disproportionnée pour un besoin qui se règle avec un simple flux JSON.
Cet article fait le tour des alternatives à un serveur MCP quand le besoin réel est plus modeste qu’une intégration agentique complète. L’idée n’est pas d’opposer les approches, mais de choisir la bonne échelle d’outillage selon ce que l’agent doit réellement faire avec votre site.
Pourquoi ne pas toujours partir sur MCP
Le Model Context Protocol standardise la façon dont un agent découvre et appelle des outils, lit des ressources et récupère des prompts auprès d’un serveur. C’est excellent quand l’agent doit interagir avec le site de façon dynamique : chercher, filtrer, déclencher une action, enchaîner plusieurs appels selon le contexte de la conversation.
Mais un serveur MCP a un coût : il faut l’héberger, le maintenir, gérer son authentification, versionner ses schémas d’entrée et de sortie. Si le besoin se limite à « donner à un agent une vue à jour du contenu du site », ce coût n’est souvent pas justifié.
Le flux JSON dédié
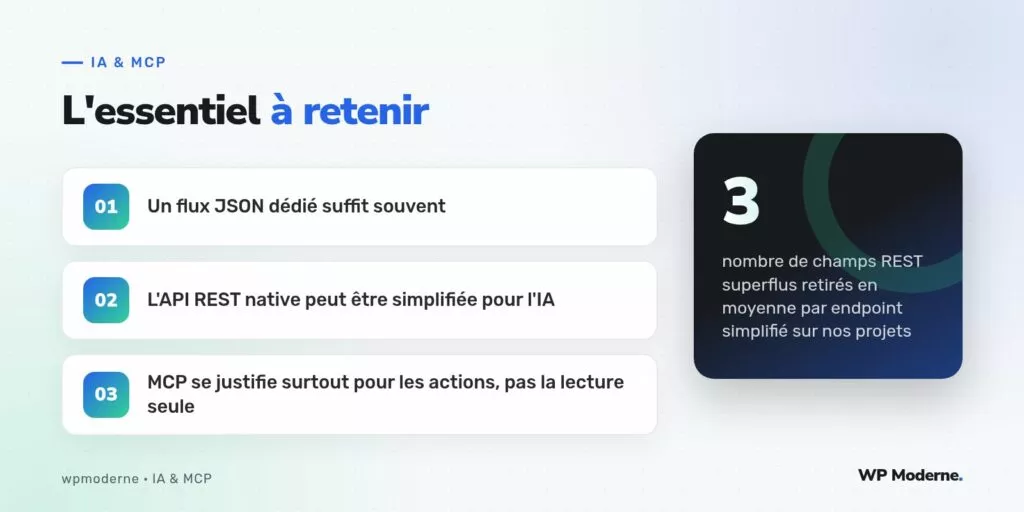
La solution la plus simple reste un point d’accès unique qui expose un export structuré du contenu pertinent : articles publiés, métadonnées, éventuellement un résumé. Contrairement à un flux RSS, on contrôle exactement les champs exposés et leur format, pensé pour être consommé par un modèle plutôt que par un lecteur de flux.
add_action( 'rest_api_init', function () {
    register_rest_route( 'agent-feed/v1', '/articles', array(
        'methods'             => 'GET',
        'callback'            => 'agence_feed_articles',
        'permission_callback' => '__return_true',
    ) );
} );

function agence_feed_articles() {
    $articles = get_posts( array(
        'post_type'      => 'post',
        'post_status'    => 'publish',
        'posts_per_page' => 50,
    ) );

    return array_map( function ( $post ) {
        return array(
            'id'      => $post->ID,
            'titre'   => get_the_title( $post ),
            'resume'  => wp_trim_words( wp_strip_all_tags( $post->post_content ), 60 ),
            'url'     => get_permalink( $post ),
            'maj'     => get_the_modified_date( 'c', $post ),
        );
    }, $articles );
}
Ce flux se met en cache facilement, se documente en une page, et ne demande aucune bibliothèque cliente particulière côté agent : n’importe quel outil capable de faire une requête HTTP peut le consommer.
L’API REST simplifiée
L’API REST de WordPress existe déjà, mais elle expose souvent beaucoup plus de champs que nécessaire : guid, ping_status, les liens _links complets, les rendus HTML bruts. Un modèle de langage traite ce bruit comme du contexte à interpréter, ce qui augmente le nombre de jetons consommés sans apporter d’information utile.
On peut restreindre la réponse avec le paramètre _fields :
GET /wp-json/wp/v2/posts?_fields=id,title,excerpt,link,modifiedC’est rapide à mettre en place et ne demande aucun développement, mais reste limité : impossible d’agréger des données de plusieurs types de contenu en un seul appel, ou de calculer un champ dérivé sans filtre personnalisé.
Les fichiers statiques générés
Pour un contenu qui change peu, un export statique régénéré à chaque publication (via un hook save_post ou une tâche wp_schedule_event) peut suffire : un fichier JSON servi directement par le serveur web, sans passer par PHP ni par la base de données à chaque requête de l’agent.
- Aucune charge supplémentaire sur le site au moment de la consultation par l’agent.
- Une latence minimale, utile si l’agent interroge le flux à haute fréquence.
- Un inconvénient : la fraîcheur des données dépend de la fréquence de régénération.
Où MCP redevient nécessaire
Dès que l’agent doit faire plus que lire : créer un brouillon, modifier un statut, déclencher une recherche paramétrée avec plusieurs critères combinés, ou enchaîner une séquence d’actions dépendantes les unes des autres, un simple flux ne suffit plus. C’est là que la notion d’outil avec un schéma d’entrée déclaré, que MCP formalise, prend tout son sens : l’agent doit savoir précisément quels paramètres il peut envoyer et ce qu’il recevra en retour.
Notre repère : si la question se résume à « lire », un endpoint suffit. Si elle inclut « décider » ou « agir », il faut un contrat d’outil plus formel.
En résumé
Avant d’écrire un serveur MCP, posez-vous la question du besoin réel : consultation ponctuelle, lecture répétée, ou véritable action sur le site. Un flux JSON dédié ou une API REST filtrée couvrent une large part des usages de lecture, avec beaucoup moins de code à maintenir. Réservez MCP aux cas où l’agent doit décider et agir, pas seulement consulter.