Un client du secteur du bâtiment nous a confié un problème récurrent : des centaines de fiches produit fournisseurs, reçues en PDF, devaient être transformées en pages produit WooCommerce. La saisie manuelle prenait un temps considérable. Nous avons construit un flux qui envoie chaque PDF à un modèle de vision, récupère les champs utiles et propose une fiche à valider avant publication. Ce n’est pas un article sur la génération d’images : uniquement sur la lecture de documents existants.
Voici la méthode complète, du fichier importé dans la médiathèque jusqu’au contenu WordPress créé, avec les points de vigilance qui font la différence entre un gain de temps réel et un chantier de corrections sans fin.
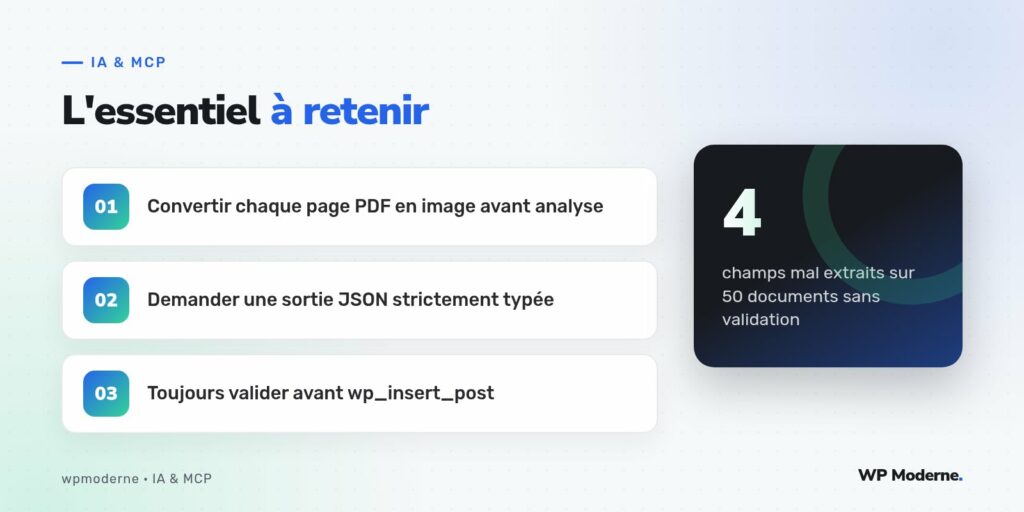
Étape 1 : convertir le PDF en images exploitables
La plupart des modèles de vision actuels n’acceptent pas directement un fichier PDF multi-pages en entrée fiable : mieux vaut convertir chaque page en image avant l’envoi. Sur le serveur, nous utilisons Imagick, déjà présent sur beaucoup d’hébergements WordPress, pour générer un PNG par page au moment de l’upload dans la médiathèque, via le hook add_attachment.
add_action( 'add_attachment', function ( $attachment_id ) {
    $file = get_attached_file( $attachment_id );
    if ( 'application/pdf' !== get_post_mime_type( $attachment_id ) ) {
        return;
    }
    $imagick = new Imagick();
    $imagick->setResolution( 150, 150 );
    $imagick->readImage( $file . '[0]' );
    $imagick->setImageFormat( 'png' );
    $png_path = str_replace( '.pdf', '-page1.png', $file );
    $imagick->writeImage( $png_path );
} );
Étape 2 : construire un prompt d’extraction strict
La qualité de l’extraction dépend presque entièrement de la précision du prompt. Nous demandons systématiquement une sortie JSON avec un schéma explicite, plutôt qu’un texte libre à reparser ensuite. Le prompt liste chaque champ attendu, son type, et une consigne claire : renvoyer null plutôt qu’inventer une valeur absente.
Étape 3 : parser et faire correspondre les champs WordPress
La réponse du modèle arrive en JSON. Nous la décodons avec json_decode, vérifions la présence des clés attendues, puis mappons chaque champ vers son emplacement WordPress : titre du produit, description, prix vers les métadonnées WooCommerce, référence fournisseur vers un champ personnalisé. Toute valeur manquante ou de type incorrect place la fiche en brouillon avec une alerte plutôt que de la publier en l’état.
$data = json_decode( $response_json, true );
if ( ! isset( $data['reference'], $data['prix_ht'] ) ) {
    wp_insert_post( array(
        'post_title'  => $data['nom_produit'] ?? 'À vérifier',
        'post_status' => 'draft',
        'post_type'   => 'product',
    ) );
    return;
}
Étape 4 : la validation humaine, non négociable
Sur un lot de test de cinquante fiches fournisseurs, nous avons comparé les extractions automatiques à une saisie manuelle de référence. Quatre champs se sont révélés incorrects sans intervention : deux prix mal lus à cause d’une mise en page en deux colonnes, une référence tronquée et une unité de mesure confondue entre kilogrammes et litres. Aucun de ces cas n’était visible sans relecture, ce qui confirme la nécessité d’un statut brouillon systématique avant toute publication automatique.
- Toujours passer par un statut brouillon avant publication
- Afficher côte à côte la page PDF source et les champs extraits pour la relecture
- Journaliser chaque extraction avec le fichier source associé
- Revoir en priorité les documents à mise en page complexe ou multi-colonnes
Étape 5 : industrialiser sans perdre le contrôle
Une fois le flux validé, nous avons ajouté une file de traitement pour éviter de bloquer l’upload le temps de l’appel au modèle, avec un statut « en cours d’extraction » affiché dans la liste des médias. Le gain de temps reste net : une fiche qui prenait dix minutes de saisie manuelle passe à moins de deux minutes de relecture.
Un modèle de vision ne remplace pas la saisie, il la transforme en relecture. La différence de temps se joue là, pas dans l’automatisation totale.
Pour aller plus loin
Ce flux s’adapte facilement aux factures fournisseurs pour l’automatisation de la comptabilité, ou aux fiches techniques pour l’import massif de contenus B2B. La règle reste la même : un schéma de sortie strict, un statut brouillon par défaut, et une relecture humaine sur les documents à structure inhabituelle. C’est ce dernier point, souvent négligé, qui fait la différence entre un outil fiable et une source d’erreurs discrètes dans le catalogue.