Un site institutionnel publié en français, anglais, allemand et italien accumulait un décalage croissant entre la langue source et les traductions : certains articles restaient plusieurs semaines sans version dans une langue cible, faute de temps disponible chez les traducteurs internes. L’objectif du projet n’était pas de remplacer la traduction humaine, mais d’éliminer le temps perdu à repérer manuellement ce qui manquait encore.
Cet article détaille l’architecture retenue, volontairement construite autour d’une détection automatique et d’une proposition, jamais d’une publication autonome. La traduction par IA sans agent, plus simple, est traitée séparément ailleurs sur ce blog : ici, l’enjeu porte sur l’orchestration du pipeline complet.
Vue d’ensemble du pipeline
Publication d'un article en langue source (FR)
        │
        ▼
 Agent orchestrateur (via serveur MCP)
        │
   ┌────┼─────────┬─────────┐
   ▼    ▼         ▼         ▼
  EN   DE        IT     (langue cible)
   │    │         │
   ▼    ▼         ▼
Détection : traduction existante ? à jour ?
        │
        ▼
Si absente ou obsolète → proposition de traduction
        │
        ▼
File d'attente de validation (par langue)
        │
        ▼
Publication dans la langue cible (validée uniquement)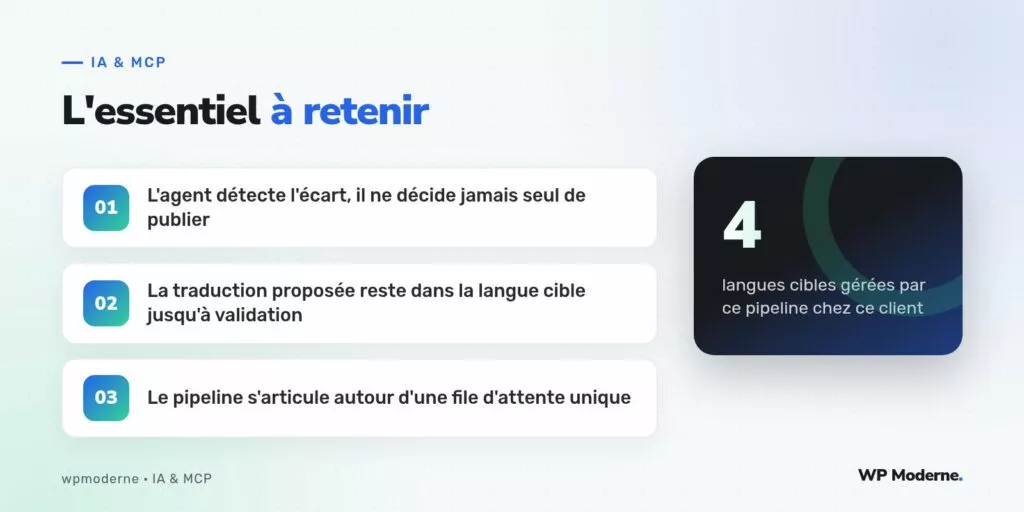
La détection des écarts
Le serveur MCP expose un outil check_translation_status qui compare, pour chaque article source publié, la présence et la date de modification de sa version dans chaque langue cible (le site utilise une extension multilingue qui relie les contenus entre eux par un identifiant commun). Une traduction absente ou plus ancienne que la dernière modification de la source déclenche la suite du pipeline.
{
  "name": "check_translation_status",
  "inputSchema": {
    "type": "object",
    "properties": {
      "source_post_id": { "type": "integer" },
      "langue_cible": { "type": "string", "enum": ["en", "de", "it"] }
    },
    "required": ["source_post_id", "langue_cible"]
  }
}
La proposition de traduction
Une fois un écart détecté, l’agent génère une proposition de traduction complète, déposée en tant que brouillon lié à la langue cible, sans jamais toucher au contenu déjà publié dans cette langue s’il en existe un. Le titre, le contenu et les métadonnées SEO de base sont traduits ensemble, pour éviter qu’un traducteur humain découvre un titre traduit sans corps d’article correspondant.
- Le brouillon reste explicitement marqué comme généré par l’agent, visible dans l’interface d’édition.
- Aucune notification n’est envoyée aux visiteurs du site tant que la traduction reste au statut brouillon.
- La proposition inclut un lien direct vers l’article source, pour faciliter la comparaison ligne à ligne.
La file de validation par langue
Chaque traducteur dispose d’une file filtrée sur sa langue de responsabilité, listant les brouillons en attente avec leur ancienneté. La validation humaine reste le seul chemin vers la publication : un brouillon généré peut être corrigé directement dans l’éditeur avant d’être publié, exactement comme n’importe quel autre brouillon du site.
Le gain de ce pipeline n’est pas d’éliminer le traducteur, mais de lui éviter de découvrir qu’un article attend depuis trois semaines une traduction que personne n’avait remarquée.
Gérer les cas particuliers
Certains contenus (mentions légales, pages contractuelles) ont été explicitement exclus du pipeline automatique : leur traduction reste intégralement confiée à un prestataire spécialisé, sans intervention de l’agent. Cette exclusion est gérée par une simple liste d’identifiants de catégories ignorées par l’outil de détection, vérifiée à chaque exécution.
Résultat après deux mois
Le délai moyen entre la publication d’un article source et la disponibilité d’un brouillon de traduction est passé de plusieurs semaines à moins de 48 heures. Le temps de relecture humaine par les traducteurs n’a pas diminué de façon spectaculaire, mais leur travail a changé de nature : ils ne partent plus d’une page blanche, ils corrigent une proposition déjà structurée.
En résumé
Un pipeline de traduction assisté par agent gagne à séparer strictement trois rôles : la détection automatique de l’écart, la génération d’une proposition, et la validation humaine avant publication. C’est cette séparation, plus que la qualité brute de la traduction générée, qui a permis au client d’adopter durablement l’outil sans crainte de publication non maîtrisée.