Comment récupérer un jeu de données représentatif d’une boutique WooCommerce de plusieurs dizaines de milliers de commandes, sans faire transiter des gigaoctets sur une connexion de bureau tous les lundis matin ? La question se pose dès qu’une base de production dépasse quelques centaines de mégaoctets, seuil au-delà duquel un export brut devient pénible à manipuler au quotidien.
Un freelance qui reprend un projet existant, ou qui doit reproduire un bug signalé par le client, se heurte régulièrement à ce dilemme : soit il travaille sur un jeu de données de démonstration qui ne ressemble à rien de réel, soit il attend vingt minutes qu’un export complet se termine avant de pouvoir commencer.
Ce qu’un dump complet contient réellement
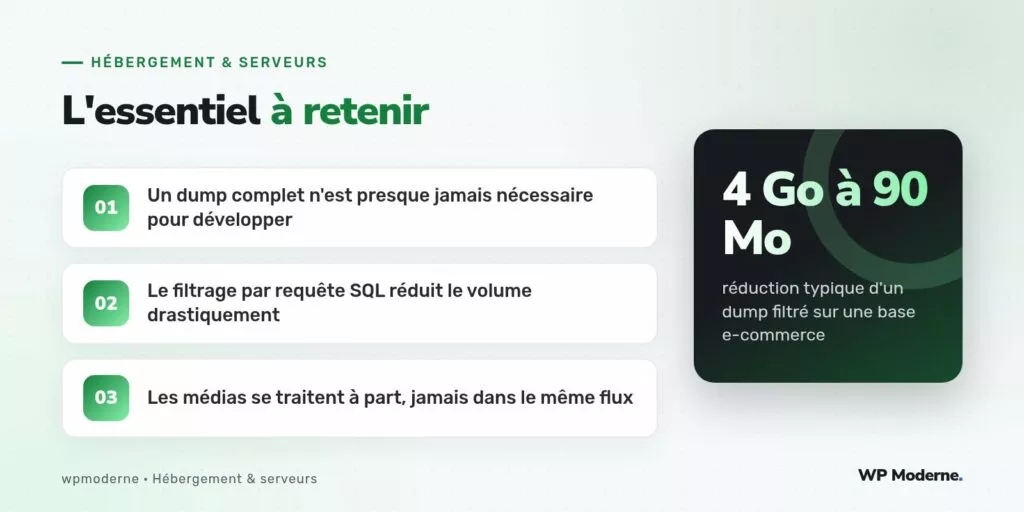
Une base WordPress volumineuse porte rarement son poids dans les tables de contenu elles-mêmes. Sur un site WooCommerce actif depuis plusieurs années, les tables wp_postmeta, wp_woocommerce_order_items et les journaux d’action planifiée (wp_actionscheduler_logs) concentrent l’essentiel du volume, alors qu’elles n’apportent presque rien pour reproduire un problème d’affichage ou tester une nouvelle fonctionnalité.
Filtrer avant d’exporter, plutôt qu’après
WP-CLI permet d’exporter une base en excluant certaines tables du dump, ce qui réduit déjà nettement le volume sans toucher à la structure :
wp db export dump-allege.sql \
  --exclude_tables=wp_actionscheduler_logs,wp_actionscheduler_actions
Pour aller plus loin, il est possible de limiter le nombre de commandes exportées directement via une requête SQL personnalisée, en ne conservant que les cent dernières, largement suffisantes pour tester l’affichage du tableau de bord ou une extension de facturation :
wp db query "SELECT * FROM wp_posts WHERE post_type='shop_order' \
  ORDER BY ID DESC LIMIT 100" > commandes-recentes.sql
Le point de vigilance : les relations entre tables
Filtrer une table de commandes sans filtrer en parallèle les tables de métadonnées associées produit une base incohérente, où des lignes de wp_postmeta pointent vers des identifiants de commande qui n’existent plus. Le script de filtrage doit donc toujours traiter les tables liées ensemble, jamais isolément.
Un script reproductible plutôt qu’une manipulation manuelle
La bonne pratique consiste à écrire ce filtrage une fois, sous forme de script bash appelé à chaque synchronisation, plutôt que de retaper des requêtes SQL à la main à chaque fois :
#!/usr/bin/env bash
set -euo pipefail

IDS=$(wp db query "SELECT ID FROM wp_posts WHERE post_type='shop_order' \
  ORDER BY ID DESC LIMIT 100" --skip-column-names)

wp db export - --tables=wp_posts,wp_postmeta \
  --where="ID IN (${IDS// /,})" > extrait-commandes.sql
Les médias : un flux totalement séparé
Les fichiers physiques attachés aux commandes, factures PDF ou images produit, ne transitent jamais par un export SQL. Un simple rsync ciblé, limité aux fichiers réellement référencés par l’extrait de base, évite de rapatrier l’intégralité de la médiathèque :
rsync -avz --files-from=liste-fichiers-utilises.txt \
  utilisateur@serveur-production:/var/www/wp-content/uploads/ \
  ./wp-content/uploads/
Importer proprement en local
Une fois l’extrait rapatrié, l’import et le remplacement d’URL se font en deux commandes, la seconde toujours précédée d’un essai à blanc :
wp db import extrait-commandes.sql;wp search-replace 'https://boutique-client.fr' 'https://boutique-client.local' --dry-run;- puis la même commande sans
--dry-runune fois le résultat vérifié.
Une habitude qui a évité plus d’un incident sur nos projets : ne jamais lancer
search-replacesans l’option--dry-runau moins une fois, même sur un environnement local sans conséquence apparente.
Pour aller plus loin
Ce flux allégé se documente une fois par projet dans un fichier Makefile ou un script unique versionné, afin que toute personne qui reprend le projet dispose du même raccourci sans avoir à redécouvrir la structure de la base à chaque fois. La différence entre attendre vingt minutes et attendre quinze secondes ne tient qu’à ce script écrit une bonne fois pour toutes.