Ce jour de février, les réseaux sociaux se sont rapidement remplis de captures d’écran de pages d’erreur : de nombreux sites majeurs, dépendant d’un même grand fournisseur de CDN, se sont retrouvés inaccessibles pendant plusieurs heures suite à une panne globale de son infrastructure. Sur le parc de sites WordPress gérés par l’agence, le même CDN était utilisé sur la majorité des projets. Et pourtant, aucun n’a affiché de page d’erreur ce jour-là.
Ce récit ne cherche pas à dérouler une méthodologie générale de mise en place de CDN, déjà couverte par ailleurs sur ce blog, mais à raconter précisément ce qui, dans l’architecture de repli déjà en place, a permis d’éviter la panne ce jour précis.
Ce que le CDN faisait habituellement
Sur ce parc, le CDN sert principalement à mettre en cache les pages HTML complètes et les fichiers statiques (images, CSS, JavaScript) au plus près des visiteurs, réduisant la charge sur les serveurs d’origine et la latence perçue. En fonctionnement normal, une grande partie des requêtes ne touche jamais le serveur d’origine WordPress, entièrement servies depuis le cache du CDN.
Le principe du mode origin-only en repli
La configuration du CDN sur ces projets inclut une règle de santé (health check) qui surveille en continu la disponibilité du réseau du CDN lui-même depuis le point de vue du navigateur, via un mécanisme de bascule DNS conditionnelle configuré chez le fournisseur DNS, distinct du CDN. Quand le CDN cesse de répondre correctement au-delà d’un seuil défini, la résolution DNS bascule automatiquement vers l’adresse IP du serveur d’origine, contournant entièrement le CDN défaillant.
# Politique de bascule DNS conditionnelle (principe simplifié)
exemple.fr.  A  ; via CDN si santé OK
             failover-policy: PRIMARY=cdn, SECONDARY=origin
             health-check: https://cdn.exemple.fr/healthz
             threshold: 3 échecs consécutifs sur 30s
Ce principe de bascule automatique, entièrement configuré côté DNS et indépendant du CDN concerné, a fait exactement son travail ce jour-là : dès que le seuil d’échecs consécutifs a été atteint, les résolutions DNS suivantes ont pointé directement vers l’IP du serveur d’origine, sans dépendre du CDN en panne pour effectuer cette bascule.
Ce que les visiteurs ont réellement vécu
| Aspect | Avant la bascule | Pendant la panne, après bascule |
|---|---|---|
| Disponibilité | 100 %, servie par le CDN | 100 %, servie directement par l’origine |
| Latence perçue | Faible, cache proche du visiteur | Plus élevée, un seul point de service |
| Fichiers statiques (images, CSS) | Servis par le CDN | Servis directement par le serveur d’origine |
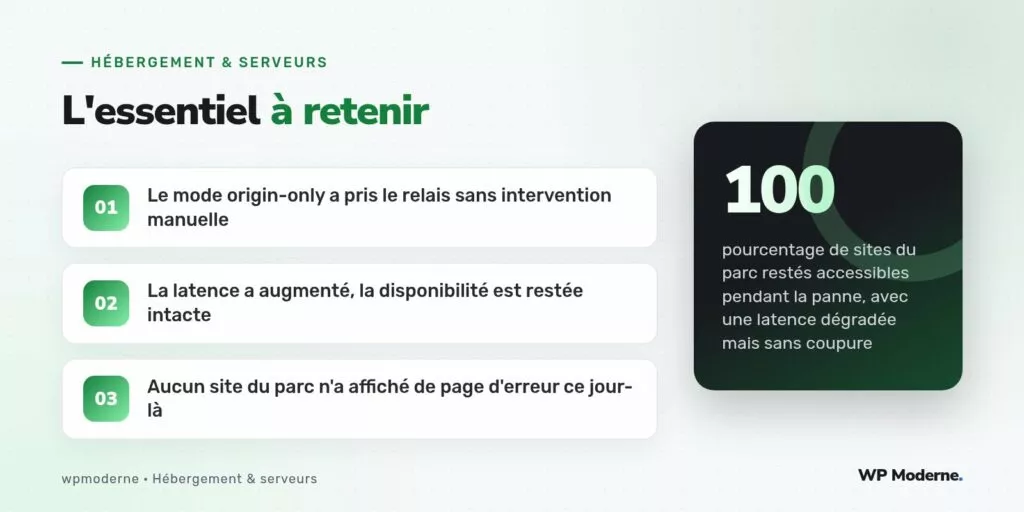
La latence a augmenté sensiblement pour les visiteurs les plus éloignés géographiquement du serveur d’origine, faute de points de présence intermédiaires, mais aucun site n’est devenu inaccessible. Le compromis assumé de cette architecture de repli est précisément celui-là : accepter une dégradation de performance en cas de panne du CDN plutôt qu’une indisponibilité complète.
Ce qui a nécessité une vérification manuelle malgré tout
- La capacité du serveur d’origine à absorber directement l’intégralité du trafic habituellement filtré par le cache du CDN, vérifiée a posteriori sur les journaux d’accès du jour.
- Les certificats TLS du serveur d’origine, qui doivent rester valides et à jour même lorsqu’ils ne sont normalement jamais exposés directement aux visiteurs.
- Les règles de pare-feu applicatif habituellement gérées par le CDN (protection anti-bot, limitation de débit), absentes en mode origin-only, un point de vigilance accepté pour la durée de la panne.
Une architecture de repli qui dégrade la performance plutôt que de couper le service n’est pas un échec de conception : c’est exactement le compromis qu’elle a été pensée pour offrir le jour où le composant principal tombe.
Ce que cette panne n’a pas testé
Cette bascule automatique a fonctionné parce que la panne touchait spécifiquement le CDN, pas le serveur d’origine lui-même. Un scénario différent, où le serveur d’origine serait simultanément indisponible, n’aurait laissé aucune option de repli dans cette configuration précise, un angle mort assumé plutôt que traité par une redondance d’origine supplémentaire, jugée disproportionnée au regard du profil de risque de ce parc.
En résumé
La panne mondiale de ce CDN majeur n’a eu aucun impact visible sur la disponibilité des sites de ce parc, non pas parce que le CDN n’a pas eu de problème, mais parce qu’une bascule DNS conditionnelle vers le serveur d’origine avait été configurée en amont, indépendamment du fournisseur CDN lui-même. Le prix payé ce jour-là a été une latence dégradée pour les visiteurs les plus éloignés, un compromis largement préférable à une page d’erreur.