Warning: fwrite(): write failed, reason: Disk quota exceeded in /var/www/html/wp-content/uploads/2026/07/photo.jpg. Cette erreur PHP apparaît lors d’un import de médias sur un site WordPress hébergé sur un cluster de fichiers distribué à trois nœuds, en principe transparent pour l’application. Le problème : la même opération, relancée immédiatement après, réussit parfaitement. Et surtout, l’erreur ne survient que lorsque l’écriture atterrit sur un nœud précis du cluster, jamais sur les deux autres.
Ce billet ne discute pas du choix d’un système de fichiers distribué en particulier, une décision d’architecture distincte. Il décrit une méthode de diagnostic applicable à ce type de cluster, quel que soit le logiciel utilisé, dès lors qu’une erreur de quota apparaît de façon incohérente selon le nœud sollicité.
Symptôme
Le quota global configuré sur le volume partagé du cluster reste largement sous son seuil, confirmé par la commande d’administration du cluster qui rapporte une occupation logique cohérente avec l’espace attendu. Pourtant, l’erreur de quota dépassé survient de façon intermittente, uniquement lorsque l’écriture cible physiquement le nœud numéro deux du cluster, identifiable via les journaux applicatifs qui tracent l’adresse du nœud ayant traité chaque requête.
Une vérification rapide de l’espace disque physique sur chacun des trois nœuds révèle l’anomalie :
node1$ df -h /data
Filesystem      Size  Used Avail Use% Mounted on
/dev/vdb1        500G  210G  290G  42% /data

node2$ df -h /data
Filesystem      Size  Used Avail Use% Mounted on
/dev/vdb1        500G  480G   20G  96% /data

node3$ df -h /data
Filesystem      Size  Used Avail Use% Mounted on
/dev/vdb1        500G  225G  275G  45% /data
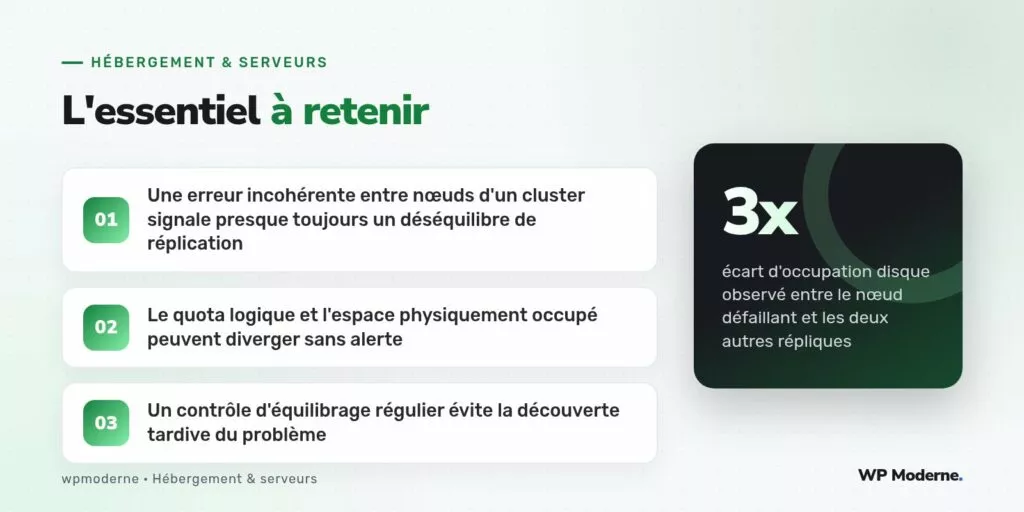
Le nœud deux occupe près de trois fois plus d’espace physique que les deux autres, alors que le cluster est censé répartir les fragments de données de façon équilibrée entre ses trois membres.
Diagnostic
Ce déséquilibre provient presque toujours d’un même mécanisme : le cluster de fichiers distribue les nouveaux fragments selon un algorithme de placement qui suppose un espace disponible comparable sur chaque nœud au moment de la décision. Si un nœud a rejoint le cluster plus tard, avec un historique de fragments déjà présents avant sa jonction, ou si un rééquilibrage automatique a été désactivé ou interrompu à un moment donné, l’algorithme continue de considérer ce nœud comme un candidat normal pour de nouvelles écritures, sans tenir compte de son occupation réelle déjà élevée.
Dans ce cas précis, l’historique des journaux d’administration du cluster a montré qu’un processus de rééquilibrage, censé tourner en tâche de fond chaque nuit, avait été interrompu plusieurs semaines auparavant suite à une mise à jour du logiciel de cluster, sans que l’échec ne remonte d’alerte visible. Le nœud deux avait continué à accumuler des fragments à un rythme normal, sans jamais être déchargé par le mécanisme de rééquilibrage censé compenser cette accumulation.
Correctif
La correction immédiate a consisté à relancer manuellement le processus de rééquilibrage du cluster, en vérifiant d’abord qu’il ne créerait pas de charge réseau excessive aux heures de trafic :
# Vérifier l'état du rééquilibrage
cluster-admin rebalance status

# Relancer le processus s'il est arrêté
cluster-admin rebalance start --throttle=moderate

# Suivre la progression
cluster-admin rebalance status --watch
Le rééquilibrage a redistribué progressivement une partie des fragments du nœud deux vers les deux autres nœuds, ramenant en quelques heures l’occupation disque à un niveau comparable entre les trois membres du cluster, sans interruption de service pendant l’opération.
Prévention
Pour éviter qu’un déséquilibre similaire ne passe inaperçu pendant plusieurs semaines, trois mesures ont été mises en place après cet incident :
- Une alerte de supervision dédiée à l’écart d’occupation disque entre les nœuds du cluster, déclenchée dès qu’un nœud dépasse de plus de 20 points de pourcentage la moyenne des autres.
- Une vérification explicite, après chaque mise à jour du logiciel de cluster, que le processus de rééquilibrage automatique reprend correctement son exécution planifiée.
- Un contrôle mensuel manuel de l’état de rééquilibrage, indépendant de l’alerte automatique, pour détecter un échec silencieux qui n’aurait pas déclenché le seuil configuré.
Une erreur de quota qui ne touche qu’un seul nœud d’un cluster censé être homogène n’est presque jamais un problème de quota : c’est un problème de répartition.
En résumé
Une erreur « disk quota exceeded » incohérente entre les nœuds d’un cluster de fichiers distribué pointe rarement vers un vrai dépassement de quota global, mais vers un déséquilibre de répartition physique des données, souvent causé par l’échec silencieux d’un processus de rééquilibrage. Comparer l’occupation disque physique nœud par nœud, avant même de questionner le quota logique configuré, permet d’identifier rapidement ce type de situation.