add_filter( 'rest_prepare_post', 'ajouter_temps_lecture', 10, 3 ); — voilà, à lui seul, ce bout de code règle un problème que beaucoup de développeurs headless résolvent par un endpoint personnalisé alors qu’un simple filtre suffit. Le filtre rest_prepare_post s’exécute juste avant l’envoi de la réponse REST pour chaque article, et permet d’y ajouter, retirer ou modifier des champs sans toucher au schéma de la route existante.
Cette approche évite de multiplier les appels réseau côté front découplé : au lieu d’interroger un endpoint supplémentaire pour récupérer une donnée dérivée (temps de lecture, nombre de mots, résumé automatique), le front reçoit tout dans la réponse standard de /wp/v2/posts. Voyons comment l’implémenter proprement, et où elle montre ses limites.
Le filtre rest_prepare_post en détail
La fonction rest_prepare_post reçoit trois arguments : l’objet WP_REST_Response déjà construit, l’objet WP_Post source, et la requête REST courante sous forme de WP_REST_Request. C’est en manipulant le premier argument que l’on ajoute un champ :
add_filter( 'rest_prepare_post', function( $response, $post, $request ) {
    $contenu = get_post_field( 'post_content', $post );
    $nb_mots = str_word_count( wp_strip_all_tags( $contenu ) );
    $temps_lecture = (int) ceil( $nb_mots / 200 );

    $response->data['temps_lecture_minutes'] = $temps_lecture;

    return $response;
}, 10, 3 );
Le calcul se fait à chaque requête, ce qui signifie que la donnée est toujours fraîche : si l’article est modifié, le temps de lecture recalculé reflète immédiatement la nouvelle longueur du texte. Aucun champ personnalisé n’est stocké en base, aucune migration n’est nécessaire.
Restreindre le filtre au bon type de contenu
Ce filtre s’applique par type de contenu grâce à un suffixe dynamique. Pour ne cibler que les articles standards, rest_prepare_post convient ; pour un type personnalisé nommé guide, il faudrait accrocher le filtre sur rest_prepare_guide. Cette granularité évite d’alourdir toutes les réponses REST du site alors que seul un type de contenu a besoin du champ calculé.
Où cette technique montre ses limites
Sur une route de collection comme /wp/v2/posts?per_page=100, le filtre s’exécute une fois par article renvoyé. Un calcul léger comme un comptage de mots reste négligeable, mais un calcul qui interroge la base de données (par exemple compter les commentaires approuvés via une requête $wpdb) peut ralentir sensiblement une liste de cent éléments, chacun déclenchant sa propre requête.
Dans ce cas, deux solutions s’offrent au développeur :
- Précalculer la donnée à la publication, via le hook
save_post, et la stocker en meta pour une lecture rapide dans le filtre. - Limiter le champ calculé aux routes de détail (un seul article), en testant
$request->get_param( 'id' )ou en vérifiant le contexte de la requête.
Un champ qui respecte le schéma REST
Ajouter directement une clé dans $response->data fonctionne, mais elle n’apparaît pas dans le schéma OpenAPI généré automatiquement par WordPress, ce qui peut dérouter une équipe front qui consulte la documentation de l’API via /wp-json. Pour un champ destiné à durer, register_rest_field() reste préférable, car il déclare explicitly le type et la description du champ dans le schéma. Le filtre rest_prepare_post garde toute sa valeur pour des ajustements ponctuels, des expérimentations, ou des champs qui dépendent fortement du contexte de la requête (rôle de l’utilisateur, paramètre de langue, etc.), là où register_rest_field() serait plus rigide.
Un champ calculé bien placé dans
rest_prepare_postévite un aller-retour réseau ; mal placé sur une collection de cent éléments, il en crée cent en coulisses. Le bon réflexe consiste à toujours tester la route de liste avant de valider en production.
Vérifier l’impact avec l’outil Query Monitor
Avant de déployer ce type de filtre, il est utile de mesurer son coût réel. L’extension Query Monitor affiche le nombre de requêtes SQL déclenchées par une page, y compris pour les réponses REST consultées depuis le navigateur. Comparer le nombre de requêtes avec et sans le filtre actif permet de chiffrer précisément le surcoût, plutôt que de le supposer.
Un tableau de suivi simple, tenu sur un projet réel, aide à documenter la décision :
| Route | Requêtes sans filtre | Requêtes avec filtre |
|---|---|---|
| /wp/v2/posts/42 (détail) | 6 | 7 |
| /wp/v2/posts?per_page=50 (liste) | 9 | 58 |
L’écart sur la route de liste illustre bien pourquoi un calcul qui interroge la base ne devrait jamais être branché sans réflexion sur une collection paginée.
En résumé
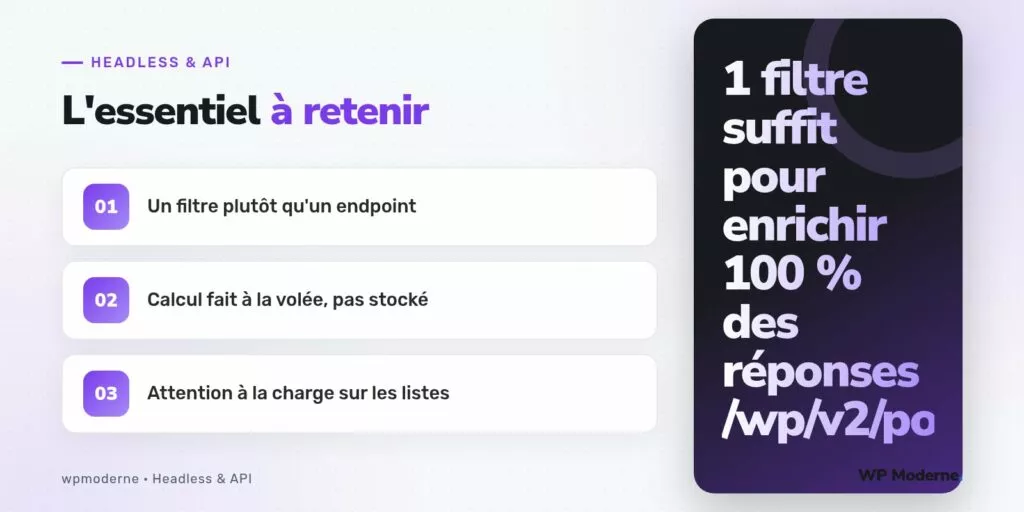
Le filtre rest_prepare_post est l’outil le plus direct pour enrichir une réponse REST existante sans créer de route supplémentaire. Il convient parfaitement à un calcul léger et sans requête, comme un temps de lecture ou un indicateur dérivé du contenu déjà chargé en mémoire. Dès que le calcul devient coûteux ou qu’il doit apparaître dans le schéma documenté de l’API, il vaut mieux basculer vers register_rest_field() ou précalculer la valeur au moment de la sauvegarde de l’article. Le choix entre ces trois approches dépend moins du champ à ajouter que du nombre d’articles renvoyés par la route qui le portera.