Un mardi matin, l’hébergeur du WordPress d’un client a subi un incident sur son infrastructure de base de données mutualisée. Le back-office est devenu injoignable pendant près de six heures, le temps que l’incident soit résolu côté hébergeur. Le site public, lui, servi par un front Next.js hébergé séparément, n’a affiché aucune erreur pendant toute la durée de la panne. Voici ce qui a permis cette différence, et ce qu’on a corrigé après coup.
Ce retour d’expérience ne traite pas du coût du headless en général, déjà couvert ailleurs : il se concentre sur ce qui, concrètement, a fait tenir le front ce jour-là.
Ce qui a marché : le cache comme filet de secours
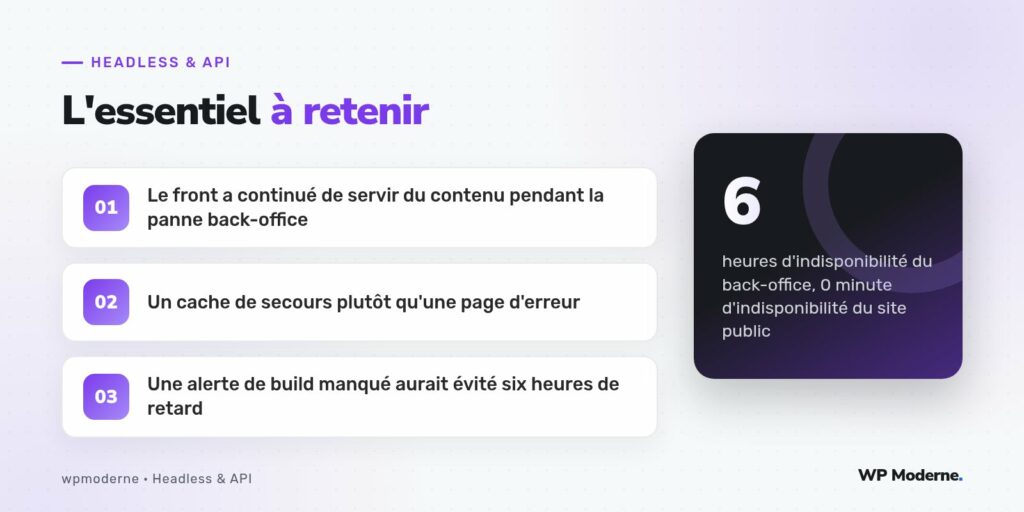
Le front interrogeait WordPress via des requêtes régénérées à intervalle régulier, avec revalidation en arrière-plan. Quand WordPress est devenu injoignable, chaque tentative de revalidation a échoué silencieusement côté serveur de rendu, mais la dernière version mise en cache est restée servie aux visiteurs sans interruption. Le site est resté figé sur son contenu de la veille au soir, ce qui restait largement acceptable pour un site éditorial sans actualité urgente ce jour-là.
Ce qui n’a pas marché : l’alerte de rebuild
Le webhook qui déclenchait normalement une reconstruction du site à chaque publication a évidemment échoué à joindre WordPress pendant l’incident, ce qui était attendu et sans conséquence. Le vrai problème est apparu après le retour du back-office : personne n’a été alerté que les tentatives de webhook avaient échoué pendant six heures, et une actualité publiée pendant la panne n’est apparue sur le site public que le lendemain matin, lors de la vérification manuelle de routine.
Ce qu’on a corrigé après l’incident
- Ajout d’une alerte automatique (envoyée sur un canal de messagerie d’équipe) dès qu’un webhook de publication échoue plusieurs fois de suite.
- Mise en place d’un contrôle de santé programmé qui interroge WordPress toutes les cinq minutes et compare son état à celui du front, indépendamment des webhooks.
- Documentation d’une procédure de reconstruction manuelle, pour ne plus dépendre uniquement du déclenchement automatique en cas de panne prolongée.
Ce que les visiteurs n’ont jamais vu
Après coup, on a comparé les journaux du serveur de rendu front avec ceux de l’hébergeur WordPress sur la fenêtre de l’incident. Aucune requête visiteur n’a échoué côté front pendant les six heures de panne : toutes ont été servies depuis le cache déjà construit. Seules les tentatives de revalidation en arrière-plan, invisibles pour un visiteur, ont échoué silencieusement pendant toute la durée de l’incident, avant de reprendre normalement dès que WordPress est redevenu joignable.
Pourquoi une architecture couplée aurait mal vécu cet incident
Sur un WordPress classique non découplé, la même panne de base de données aurait rendu le site public entièrement inaccessible, puisque chaque visite déclenche une lecture en base au moment de la requête. La séparation entre le moment où le contenu est généré (à la publication) et le moment où il est servi (à chaque visite) est précisément ce qui a absorbé cette panne sans qu’aucun visiteur ne s’en aperçoive.
| Architecture | Comportement pendant la panne base de données |
|---|---|
| WordPress couplé classique | Site public inaccessible en même temps que le back-office |
| Front découplé avec cache de secours | Site public servi normalement, contenu figé à la dernière version connue |
Un cache de secours qui sert du contenu légèrement daté vaut toujours mieux qu’une page d’erreur, tant que l’équipe sait exactement depuis combien de temps ce contenu n’a pas été rafraîchi.
Notre verdict
Cet incident n’était pas prévu, mais l’architecture a absorbé le choc sans intervention humaine pendant les six heures de panne. Le vrai enseignement porte sur la surveillance : un système de cache de secours ne suffit pas seul, il doit être accompagné d’une alerte claire dès que la chaîne de mise à jour se rompt, sinon le retard se découvre trop tard, une fois que le contenu obsolète a déjà été vu par des milliers de visiteurs.