Deux clients pour une seule API : un navigateur qui attend du HTML prêt à afficher, et un agent conversationnel qui préfère un flux structuré, débarrassé de toute mise en forme, pour raisonner sur le contenu sans avoir à parser du balisage. C’est le constat de départ d’un projet de refonte pour un comparateur de services professionnels, dont le trafic provenait de plus en plus d’agents IA consommant directement le contenu pour répondre aux questions des utilisateurs finaux, en plus des visiteurs humains classiques.
Le problème du contenu pensé pour un seul lecteur
La plupart des architectures headless partent d’un principe implicite : le contenu WordPress est transformé une fois, en HTML, destiné à un navigateur et à un humain qui le lit visuellement. Un agent IA qui consomme cette même page doit alors extraire l’information utile depuis du balisage pensé pour la mise en forme visuelle, ce qui introduit du bruit (menus de navigation, appels à l’action publicitaires, structure de mise en page) sans rapport avec le contenu informatif réellement recherché.
L’architecture retenue : négociation de contenu par en-tête Accept
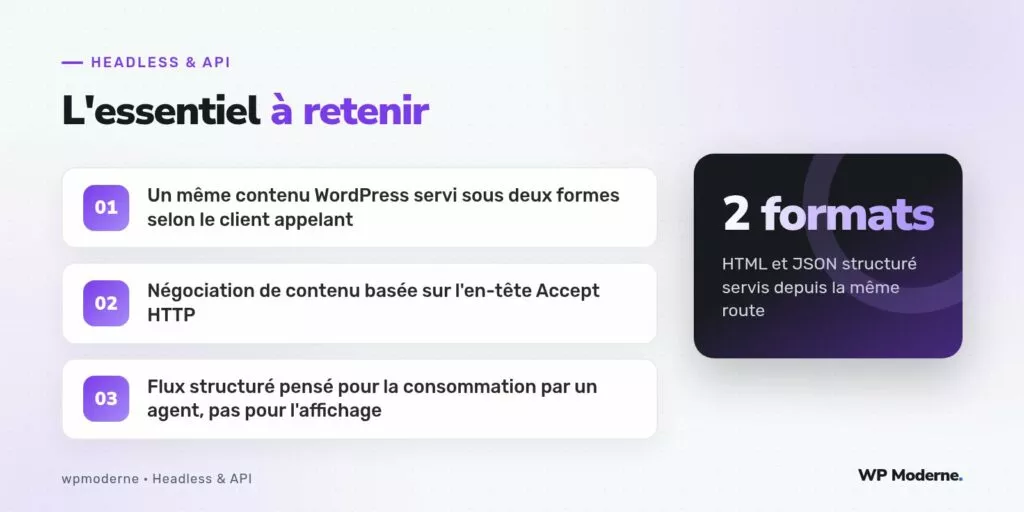
Plutôt que de dupliquer les routes ou de maintenir deux sites distincts, l’équipe a choisi de faire reposer la distinction sur un mécanisme HTTP standard et ancien : la négociation de contenu via l’en-tête Accept. Une requête classique de navigateur envoie Accept: text/html et reçoit la page rendue habituelle ; une requête d’agent, envoyant Accept: application/json ou un type MIME personnalisé, reçoit un flux structuré dédié.
export async function GET(request: Request, { params }: { params: { slug: string } }) {
  const accept = request.headers.get('accept') ?? '';
  const post = await getPostBySlug(params.slug);

  if (accept.includes('application/json')) {
    return Response.json({
      title: post.title,
      summary: post.excerpt,
      body: stripPresentationalMarkup(post.content),
      lastUpdated: post.modified,
      sourceUrl: `https://exemple.fr/services/${post.slug}`,
    });
  }

  return renderHtmlPage(post);
}
Ce que contient le flux structuré, et ce qu’il exclut délibérément
Le flux destiné aux agents ne reprend pas simplement le contenu HTML converti en texte brut : il est reconstruit à partir des données WordPress sources, avec une structure pensée pour la lecture automatisée. Il inclut le titre, un résumé, le corps du texte débarrassé de tout balisage de présentation, la date de dernière modification (essentielle pour qu’un agent sache si l’information reste à jour), et une URL source permettant de citer la page d’origine.
- Aucun élément de navigation, de publicité ou de mise en page dans le flux structuré.
- Date de dernière modification systématiquement présente, pour permettre à l’agent d’évaluer la fraîcheur de l’information.
- URL source explicite, pour permettre une citation correcte de l’origine du contenu.
Le risque d’une confusion entre les deux publics
Un piège identifié tôt dans le projet : vouloir optimiser le flux structuré au point de biaiser son contenu en faveur d’un référencement agressif auprès des agents, au détriment de l’exactitude. L’équipe a tranché en faveur d’un principe simple, formulé comme règle de conception : le flux structuré doit contenir strictement les mêmes informations factuelles que la page HTML, présentées différemment, jamais des informations supplémentaires ou orientées destinées uniquement aux agents.
Un contenu qui change de nature selon son lecteur cesse d’être fiable pour l’un des deux ; mieux vaut changer la forme du contenu que son fond, quel que soit le client qui le réclame.
Limites rencontrées et arbitrages assumés
La détection du type de client par le seul en-tête Accept reste imparfaite : certains agents envoient encore des en-têtes génériques hérités de bibliothèques HTTP standard, sans distinguer explicitement leur intention. L’équipe a ajouté une détection complémentaire, basée sur l’en-tête User-Agent, en liste blanche des agents connus, tout en conservant la négociation par Accept comme mécanisme principal, plus pérenne et standard que le filtrage par identifiant d’agent, souvent contourné ou absent.
En résumé
Concevoir un front headless pour deux publics distincts, humain et agent, ne nécessite pas de dupliquer l’infrastructure : une négociation de contenu standard, appuyée sur un en-tête HTTP existant depuis des décennies, suffit à servir deux formes différentes d’un même contenu source. La question du référencement classique de ce type d’architecture, en revanche, reste un sujet distinct qui mériterait sa propre analyse.