Le nom affiché à l’écran ne correspondait pas à celui recherché. Un habitant consultant l’annuaire des professionnels de santé d’un site intercommunal tombait, en cliquant sur la fiche du docteur Lemoine, sur celle du docteur Lemaire, publiée quelques minutes plus tôt sur une autre commune du réseau. Le signalement, remonté par un agent d’accueil qui avait lui-même halluciné devant l’écran, a déclenché une investigation qui a mis près de deux heures à aboutir, tant le symptôme semblait improbable pour une simple faute d’affichage front.
Symptôme : une fiche remplace une autre, de façon intermittente
Le comportement n’était pas systématique. La plupart des fiches s’affichaient correctement ; seules quelques-unes, publiées ou modifiées récemment, montraient parfois le contenu d’une autre fiche du réseau. Rafraîchir la page ne changeait rien immédiatement, mais attendre quelques minutes, ou consulter la fiche depuis un autre appareil, faisait parfois disparaître le problème. Cette intermittence orientait déjà l’investigation vers une couche de cache plutôt que vers un bug de rendu pur.
Diagnostic : une clé de cache construite sur le mauvais identifiant
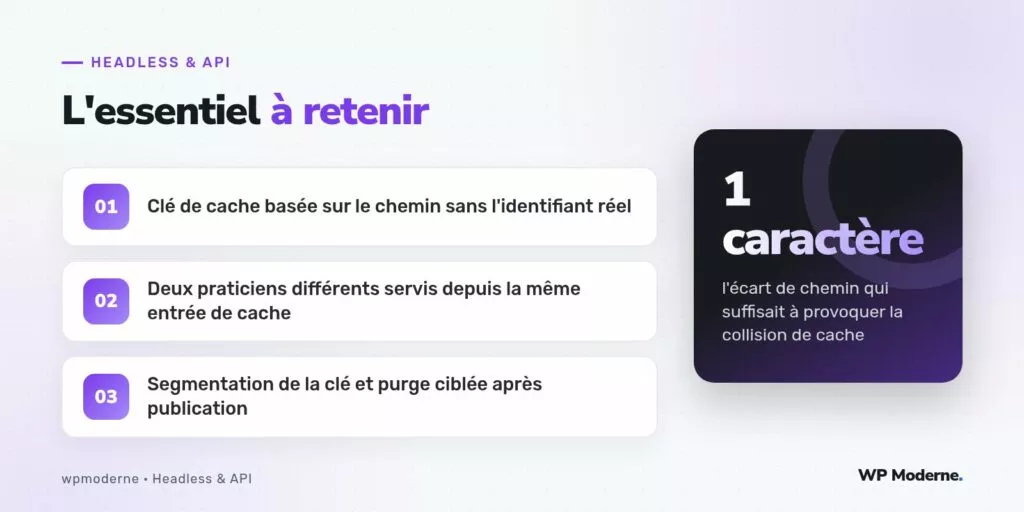
Le front, un site Next.js consommant l’API REST d’un WordPress multisite fédérant les fiches de plusieurs communes, générait chaque page praticien sur une route dynamique du type /annuaire/[commune]/[slug]. Cloudflare, configuré en cache de page complète pour soulager le serveur d’origine, construisait sa clé de cache uniquement à partir du chemin d’URL normalisé, sans tenir compte d’un en-tête interne qui distinguait pourtant deux communes ayant, par coïncidence, généré un slug de praticien quasiment identique après la normalisation des accents et espaces (« lemoine » et « le-maine » réduits tous deux à un chemin très proche après une règle de réécriture trop permissive côté serveur d’origine).
La règle de cache Cloudflare avait été écrite plusieurs mois auparavant, à l’époque où le réseau ne comptait que trois communes et où aucune collision de slug n’avait jamais été observée. Avec l’ajout progressif de nouvelles communes au fil des mois, la probabilité de collision entre deux slugs proches a mécaniquement augmenté, jusqu’à devenir un incident réel plutôt qu’un risque théorique.
Le correctif : segmenter la clé de cache par identifiant réel
La correction a consisté à reconstruire la clé de cache Cloudflare à partir de l’identifiant numérique du praticien, transmis systématiquement dans un en-tête X-Praticien-ID par le serveur d’origine, plutôt qu’à partir du seul chemin d’URL potentiellement ambigu :
{
  "cache_key": {
    "custom_key": {
      "header": {
        "include": ["x-praticien-id"]
      },
      "query_string": {
        "include": ["commune"]
      }
    }
  }
}
Cette règle, appliquée via une Cache Rule Cloudflare dédiée à la section /annuaire/, garantit désormais qu’aucune entrée de cache ne peut être partagée entre deux praticiens distincts, même en cas de slug quasi identique après normalisation.
Purger les entrées déjà corrompues
Corriger la règle de cache ne suffisait pas : les entrées déjà en cache, potentiellement fausses, devaient être purgées explicitement. L’équipe a déclenché une purge ciblée par préfixe d’URL sur l’ensemble de la section /annuaire/, plutôt qu’une purge globale du site, pour limiter l’impact sur les autres pages dont le cache restait valide :
curl -X POST "https://api.cloudflare.com/client/v4/zones/ZONE_ID/purge_cache" \
  -H "Authorization: Bearer TOKEN" \
  -H "Content-Type: application/json" \
  --data '{"prefixes":["annuaire.exemple.fr/annuaire/"]}'
Prévention : un test de collision avant chaque déploiement
Pour éviter qu’un incident similaire ne se reproduise avec un futur ajout de commune, un test automatisé a été ajouté à la chaîne d’intégration continue : à chaque synchronisation du référentiel de slugs, un script vérifie qu’aucun slug normalisé ne coïncide avec un autre, tous réseaux confondus, et bloque le déploiement en cas de collision détectée.
- Génération de la clé de cache toujours basée sur un identifiant stable, jamais sur un slug seul.
- Purge ciblée par préfixe systématique après toute correction de règle de cache.
- Test de collision de slugs intégré à la chaîne de déploiement.
Un slug lisible pour l’utilisateur et un identifiant stable pour la machine ne devraient jamais être confondus dans la construction d’une clé de cache, même quand cela semble redondant au premier abord.
En résumé
Ce type d’incident illustre un piège spécifique aux architectures headless à fort trafic : la couche de cache, souvent ajoutée après coup pour des raisons de performance, hérite rarement de la même granularité d’identification que l’application d’origine. Segmenter systématiquement les clés de cache sur des identifiants stables, et non sur des chemins d’URL potentiellement ambigus, aurait évité ce signalement dès le départ.