19 h 58, un jeudi de juillet. Le client devait lancer une nouvelle gamme à 20 h pile, avec un communiqué envoyé à sa liste de plus de trente mille abonnés au même moment. Le front, un site headless en Next.js consommant l’API REST de WordPress pour l’ensemble des pages produit, avait été livré trois semaines plus tôt et validé en recette sans accroc. Personne n’avait simulé une arrivée massive de visiteurs sur les mêmes pages en quelques secondes.
À 20 h 03, les premières alertes sont tombées : temps de réponse en forte hausse sur l’API, puis des erreurs 504 en cascade. Ce cas raconte ce qui s’est passé cette nuit-là, pas la mise en cache des réponses REST en général, un sujet qui mérite un article à lui seul et qui existe déjà ailleurs sur ce blog.
Le contexte technique du lancement
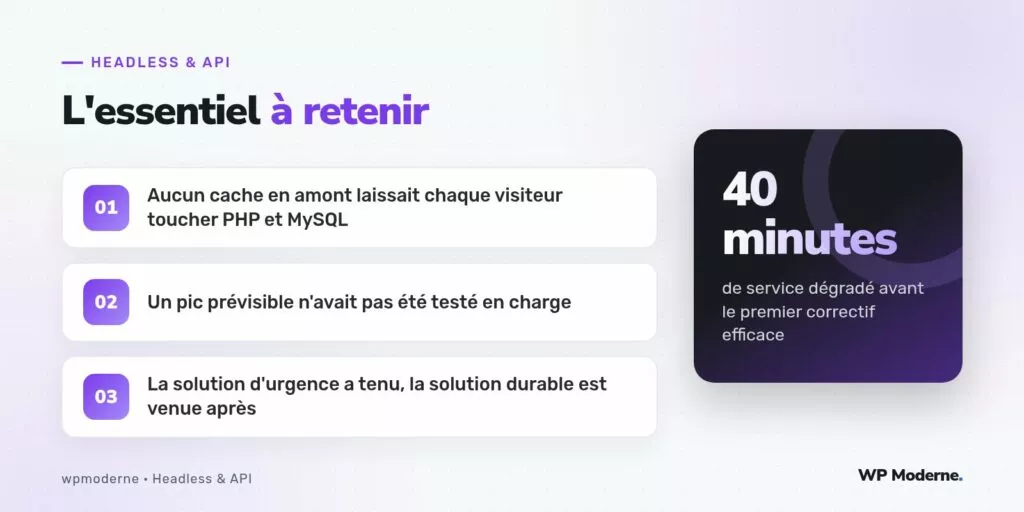
Le site tournait sur un serveur mutualisé haut de gamme, avec PHP-FPM et une instance MySQL correctement dimensionnée pour un trafic habituel. Le front Next.js utilisait la génération incrémentale, mais la page d’accueil de la nouvelle gamme avait été volontairement exclue du cache statique à la demande du client, qui voulait pouvoir modifier le stock affiché « en temps réel » jusqu’à la dernière minute avant le lancement. Résultat : chaque visiteur déclenchait un appel direct à /wp-json/wp/v2/product?slug=nouvelle-gamme, sans aucune couche de cache HTTP entre le front et WordPress.
Ce qui s’est passé minute par minute
L’email de lancement est parti à 20 h 00 précises. En moins de trois minutes, le trafic sur cette page a été multiplié par plus de cinquante par rapport au pic habituel du site. PHP-FPM a rapidement saturé son pool de processus disponibles, chaque requête attendant son tour pour interroger MySQL, qui lui-même commençait à accumuler des connexions en attente. Les temps de réponse sont passés de 200 millisecondes à plusieurs secondes, puis les premières erreurs 504 (délai dépassé côté proxy) sont apparues côté Next.js, qui affichait alors une page d’erreur générique aux visiteurs.
Le correctif d’urgence, en pleine tempête
Impossible de réécrire l’architecture en pleine soirée de lancement. Trois décisions ont été prises dans l’heure qui a suivi, dans cet ordre :
- Augmenter dans l’urgence le nombre de processus PHP-FPM disponibles, en acceptant temporairement une consommation mémoire plus élevée sur le serveur, pour absorber le pic sans redémarrage complet du service.
- Activer un cache de page très court côté serveur avec un en-tête
Cache-Control: public, max-age=30ajouté directement dans la réponse REST viarest_pre_serve_request, pour que les CDN et les navigateurs mutualisent au moins les requêtes rapprochées. - Réduire le nombre de champs renvoyés par l’API pour cette page précise, en ajoutant
_fields=title,content,acf.stock,acf.prixà l’appel du front, pour alléger chaque requête MySQL sous-jacente.
Le premier correctif à avoir vraiment stabilisé la situation a été le cache de trente secondes : quarante minutes après le début de l’incident, les temps de réponse sont redevenus acceptables et les erreurs 504 ont cessé.
Le diagnostic complet, une fois la pression retombée
Le lendemain, l’analyse des journaux a confirmé l’hypothèse : sur les cinq minutes les plus critiques, plus de quatre-vingt-dix pour cent des requêtes vers l’API concernaient exactement la même URL. Aucune de ces requêtes n’avait besoin d’une réponse différente d’une seconde à l’autre : le stock affiché n’était en réalité mis à jour manuellement par le client que deux ou trois fois dans la soirée, jamais en continu comme il l’avait imaginé.
La leçon qu’on retient de cette nuit : demandez toujours au client à quelle fréquence une donnée « en temps réel » change vraiment. Neuf fois sur dix, la réponse tient très bien avec un cache de quelques dizaines de secondes.
Ce qui a changé depuis dans notre méthode
- Tout lancement avec envoi d’email à une liste de diffusion déclenche désormais un test de charge simulé au moins deux jours avant, avec un outil simple comme
k6ouautocannon. - Aucune page attendant un pic de trafic n’est livrée sans un minimum de cache en amont, même court, même si le client demande explicitement du « temps réel ».
- Le nombre de processus PHP-FPM et les limites de connexions MySQL sont désormais documentés dans la fiche technique du projet, avec une alerte de supervision qui prévient avant la saturation plutôt qu’après.
En résumé
Un site headless n’est pas moins fragile qu’un thème WordPress classique face à un pic de trafic, il l’est parfois davantage : chaque page rendue côté front peut multiplier les appels vers une API qui, elle, reste soumise aux mêmes limites de PHP et de MySQL que n’importe quel site. Le cache n’est pas un luxe qu’on ajoute après coup, c’est une condition de survie dès qu’un lancement massif est prévisible. Cette nuit-là, l’agence a tenu, mais de justesse, et surtout grâce à une astreinte disponible au bon moment plutôt qu’à une architecture pensée pour l’occasion.