/llms.txt — c’est l’unique chemin que ce standard, apparu en septembre 2024, propose d’ajouter à la racine d’un site pour donner aux agents fondés sur des grands modèles de langage un point d’entrée texte, structuré simplement, vers le contenu jugé le plus pertinent d’un site.
Définition
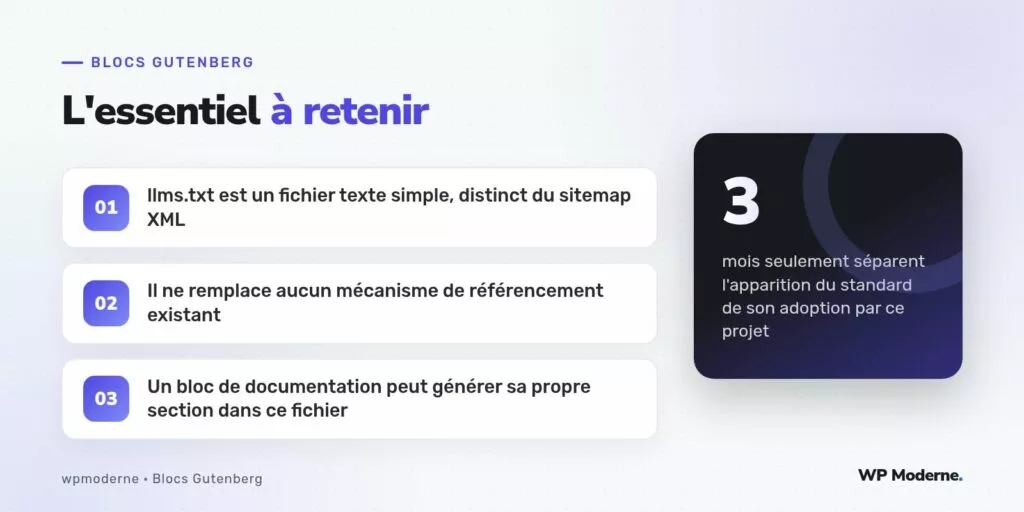
Le fichier llms.txt est un document Markdown minimal, publié à la racine du site, qui liste les pages ou sections que l’éditeur du site juge utiles à faire connaître à un agent IA venant consulter le site de façon automatisée. Il ne s’agit ni d’un protocole d’authentification, ni d’un format binaire : un simple fichier texte, lisible aussi bien par un humain que par un programme.
# Mon Projet de Documentation Technique

> Documentation de l'API de gestion de contenu pour développeurs.

## Documentation principale

- [Authentification](/docs/authentification.html) : mise en place des jetons d'accès
- [Points de terminaison](/docs/points-de-terminaison.html) : liste complète des routes disponibles

## Documentation complémentaire

- [Changelog](/docs/changelog.html) : historique des versions
Fonctionnement interne
Contrairement au sitemap XML, qui liste exhaustivement les URL d’un site pour les moteurs de recherche classiques, llms.txt ne vise pas l’exhaustivité mais la sélection : il propose un sous-ensemble de contenu jugé prioritaire, présenté avec un contexte court, en langage naturel, plutôt qu’une simple liste d’URL techniques accompagnées de métadonnées de fréquence de mise à jour.
Cas d’usage : générer la section depuis un bloc de documentation
Pour un projet qui documente son API via des blocs personnalisés (chaque bloc représentant un point de terminaison, avec ses paramètres et exemples), il devient naturel de générer automatiquement une section du fichier llms.txt à partir du contenu déjà structuré dans ces blocs, plutôt que de maintenir ce fichier à la main en parallèle :
function documentation_generer_section_llms_txt() {
    $articles_documentation = get_posts( array(
        'post_type'      => 'documentation_api',
        'posts_per_page' => -1,
    ) );

    $lignes = array( '## Documentation principale', '' );

    foreach ( $articles_documentation as $article ) {
        $lignes[] = sprintf(
            '- [%s](%s) : %s',
            get_the_title( $article ),
            get_permalink( $article ),
            get_the_excerpt( $article )
        );
    }

    return implode( "\n", $lignes );
}
Cette section générée vient ensuite s’insérer dans le fichier llms.txt publié à la racine, aux côtés d’une introduction rédigée manuellement, qui reste, elle, écrite par une personne du projet.
Ce que ce standard ne remplace pas
Le sitemap XML classique continue de jouer son rôle auprès des moteurs de recherche traditionnels, avec ses propres règles de fréquence de mise à jour et de priorité relative entre pages. llms.txt répond à un besoin différent : donner un contexte narratif court à un agent qui consulte le site de façon plus ponctuelle et plus sélective qu’un robot d’indexation classique.
- Le sitemap XML reste indispensable pour le référencement classique ;
llms.txtcomplète cette information par un contexte en langage naturel ;- Aucune balise
metani aucun en-tête HTTP particulier n’est requis pour que le fichier soit pris en compte : sa simple présence à la racine suffit.
Pièges à éviter
Le principal piège consiste à traiter llms.txt comme un mécanisme d’optimisation de référencement classique, avec des mots-clés répétés ou une liste exhaustive de toutes les pages du site. Un fichier trop long ou trop dense perd l’intérêt même du format, pensé pour rester court et sélectif. Un second piège, plus technique, consiste à générer ce fichier à chaque requête plutôt qu’à le mettre en cache ou à le régénérer uniquement lors de la publication d’un nouvel article de documentation.
Un fichier llms.txt réussi ressemble à un bon résumé de projet, pas à un index exhaustif : la sélection compte plus que l’exhaustivité.
En résumé
Trois mois seulement après l’apparition du standard, l’intégrer à un bloc de documentation technique existant reste une opération légère : générer une section structurée à partir du contenu déjà présent dans les blocs, sans dupliquer manuellement l’information, et sans toucher au sitemap XML qui conserve son rôle propre auprès des moteurs de recherche traditionnels.