Un système de recommandation d’articles connexes, alimenté par un modèle de langage externe, tourne en tâche de fond sur un site média et rédige automatiquement des propositions de titres et de résumés pour les encarts « À lire aussi ». Le constat technique posé par la rédaction en chef, après un incident, a été sans appel : deux de ces recommandations avaient été publiées automatiquement avec un titre erroné, attribuant à un article une information qu’il ne contenait pas.
Ce n’est pas un problème d’IA défaillante. C’est un problème d’architecture de publication qui ne prévoyait aucun point de contrôle humain entre la génération et la mise en ligne. Voici ce que nous avons observé, pourquoi c’est un problème, et comment corriger structurellement ce genre de flux.
Ce qu’on observe
Le plugin maison développé pour ce média interrogeait une API d’IA générative toutes les heures via une tâche wp_schedule_event, récupérait des suggestions de contenus liés, et les insérait directement en base sous forme de blocs Gutenberg dans un article existant, avec le statut publish hérité de l’article parent. Aucun statut intermédiaire, aucune notification, aucune trace visible de l’origine automatisée du contenu ajouté.
Pourquoi c’est un problème
Trois défauts distincts se cumulent dans ce schéma. D’abord, l’absence de distinction entre contenu écrit par un journaliste et contenu suggéré par un modèle : aux yeux du CMS, les deux ont exactement le même statut. Ensuite, l’absence de fenêtre de relecture : le contenu généré est visible en ligne dès son insertion, avant même qu’un humain n’ait eu l’occasion de le lire. Enfin, l’absence de traçabilité : une fois publié, rien ne distingue plus, dans l’administration, un bloc généré par IA d’un bloc rédigé à la main, ce qui rend tout audit ultérieur pénible.
Ce qu’il faut faire
La correction ne consiste pas à supprimer l’automatisation, qui reste utile pour gagner du temps, mais à insérer un sas de validation obligatoire entre la génération et la publication.
function agence_inserer_recommandation_ia( int $post_id, string $titre_suggere, string $resume ) {
    $bloc = sprintf(
        '<!-- wp:paragraph {"className":"reco-ia-pending"} --><p>%s</p><!-- /wp:paragraph -->',
        esc_html( $resume )
    );

    $post = get_post( $post_id );
    $contenu_maj = $post->post_content . $bloc;

    wp_update_post( array(
        'ID'           => $post_id,
        'post_content' => $contenu_maj,
        'post_status'  => 'pending', // jamais publish directement
    ) );

    update_post_meta( $post_id, '_agence_origine_bloc_ia', 'gpt-recommandation-v2' );
    update_post_meta( $post_id, '_agence_bloc_ia_valide', 'non' );
}
Le passage forcé au statut pending retire l’article des flux publics jusqu’à validation, même s’il était initialement publié — un comportement qu’il faut assumer et documenter auprès de la rédaction, quitte à ne déclencher ce mécanisme que sur une copie de travail plutôt que sur l’article en ligne lui-même, selon la sensibilité du média.
Rendre la validation visible et rapide
Un widget de tableau de bord, construit avec wp_add_dashboard_widget, liste chaque jour les blocs en attente de validation, avec un lien direct vers l’article et un bouton « Valider » qui bascule la meta _agence_bloc_ia_valide à oui sans repasser par l’éditeur complet.
- Chaque bloc généré porte une classe CSS distincte tant qu’il n’est pas validé, visible uniquement côté administration.
- La meta d’origine (
_agence_origine_bloc_ia) reste en base même après validation, pour un audit ultérieur. - Un journal simple, une ligne par insertion dans une table dédiée, permet de retrouver qui a validé quoi et quand.
Une IA générative n’est pas un rédacteur de plus dans l’équipe : c’est un fournisseur de brouillons. Tant qu’elle n’a pas ce statut explicite dans le workflow, elle finira par publier à la place d’un humain, un jour ou l’autre.
Prévention à long terme
Au-delà du correctif technique, la vraie prévention est organisationnelle : documenter dans la charte éditoriale que tout contenu d’origine automatisée doit porter un statut de validation explicite avant sa mise en ligne, quel que soit l’outil utilisé pour le générer. Cette règle, une fois écrite noir sur blanc, sert de référence lors de l’ajout de tout nouvel outil d’IA sur le site, bien au-delà du seul module de recommandations qui a déclenché l’incident initial.
En résumé
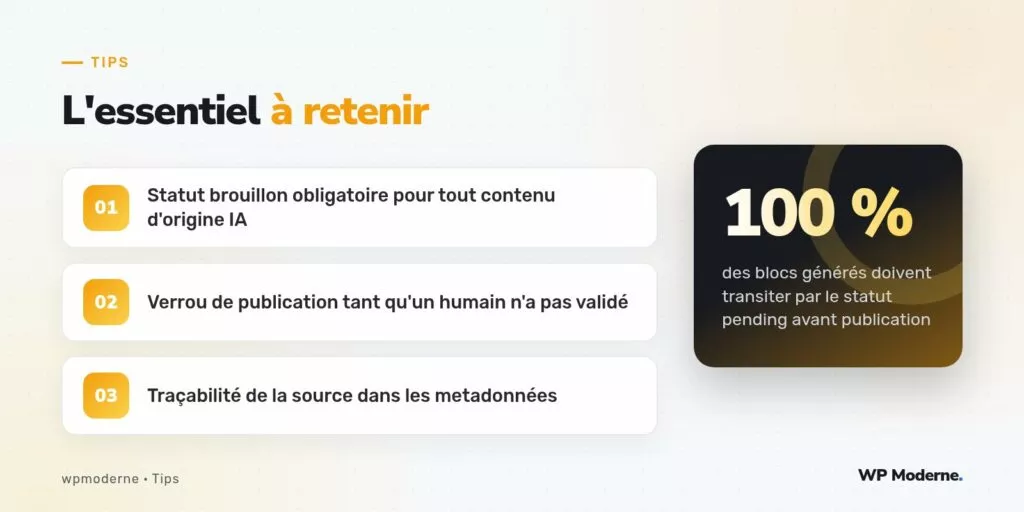
Ce n’est pas la génération automatique de contenu qui pose problème, c’est son insertion directe en production sans point de contrôle. Un statut pending forcé, une meta de traçabilité et un tableau de bord de validation suffisent à transformer un risque éditorial en simple gain de temps pour la rédaction.