Sur un site collaboratif à plusieurs dizaines de contributeurs bénévoles, une même information sur un dispositif d’aide locale s’était retrouvée publiée trois fois en quelques mois, sous des titres légèrement différents mais avec un contenu quasiment identique. Personne n’avait volontairement dupliqué l’article : chaque rédacteur ignorait simplement l’existence des deux précédents, la recherche interne du site n’étant pas assez fine pour les faire remonter avant la rédaction.
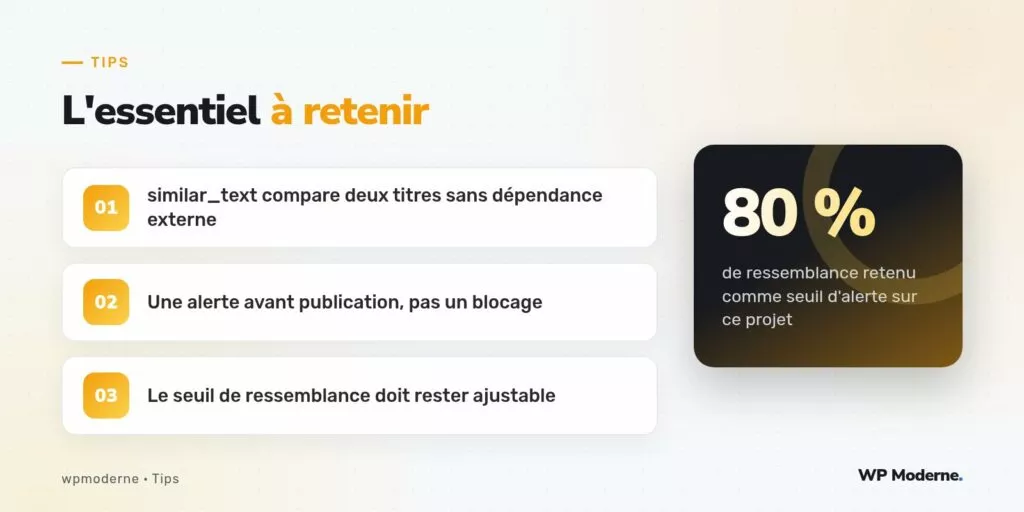
Plutôt qu’un moteur de recherche sémantique lourd à mettre en place, une comparaison de titres au moment de l’enregistrement s’est révélée largement suffisante : la fonction native PHP similar_text() calcule un pourcentage de ressemblance entre deux chaînes, sans dépendance externe ni service tiers.
Comparer le nouveau titre aux titres existants
Le hook save_post est le point d’entrée classique, mais il faut être prudent avec les sauvegardes automatiques et les révisions, qui déclenchent le même hook sans qu’il s’agisse d’une véritable nouvelle publication :
add_action( 'save_post', 'reseau_detecter_titre_proche', 10, 3 );

function reseau_detecter_titre_proche( $post_id, WP_Post $post, $mise_a_jour ) {
    if ( wp_is_post_revision( $post_id ) || wp_is_post_autosave( $post_id ) ) {
        return;
    }

    if ( 'publish' !== $post->post_status || 'post' !== $post->post_type ) {
        return;
    }

    $titres_proches = reseau_chercher_titres_proches( $post->post_title, $post_id );

    if ( ! empty( $titres_proches ) ) {
        update_post_meta( $post_id, '_alerte_doublon_possible', $titres_proches );
    } else {
        delete_post_meta( $post_id, '_alerte_doublon_possible' );
    }
}
Calculer la ressemblance
function reseau_chercher_titres_proches( string $titre, int $id_exclu ) {
    $candidats = get_posts( array(
        'post_type'      => 'post',
        'post_status'    => 'publish',
        'posts_per_page' => 200,
        'exclude'        => array( $id_exclu ),
        'fields'         => 'ids',
    ) );

    $resultats = array();

    foreach ( $candidats as $id_candidat ) {
        $titre_candidat = get_the_title( $id_candidat );

        similar_text(
            reseau_normaliser( $titre ),
            reseau_normaliser( $titre_candidat ),
            $pourcentage
        );

        if ( $pourcentage >= 80 ) {
            $resultats[] = array(
                'id'         => $id_candidat,
                'titre'      => $titre_candidat,
                'pourcentage' => round( $pourcentage ),
            );
        }
    }

    return $resultats;
}

function reseau_normaliser( string $texte ) {
    return remove_accents( mb_strtolower( trim( $texte ) ) );
}
La normalisation via remove_accents() et une mise en minuscules évite les faux négatifs liés à une simple différence de casse ou d’accentuation entre deux titres par ailleurs identiques sur le fond, ce qui arrive plus souvent qu’on ne l’imagine dans un contexte collaboratif.
Limiter le coût de la comparaison
Comparer un nouveau titre à l’ensemble des articles publiés devient coûteux passé plusieurs milliers de contenus. Sur ce projet, la limite à 200 candidats récents (via posts_per_page) a suffi, car les doublons observés concernaient presque toujours des sujets d’actualité récente republiés sans le savoir. Pour un site plus ancien où les doublons peuvent concerner des contenus de plusieurs années, on peut restreindre la comparaison à la même catégorie plutôt qu’à l’ensemble du site, ce qui réduit également le nombre de candidats à parcourir.
Afficher l’alerte à l’équipe éditoriale
Une alerte visible dans la liste des articles, réutilisant la meta posée plus haut, permet à la rédaction en chef de repérer rapidement les cas à vérifier, sans bloquer la publication (le rédacteur reste juge de la pertinence, un doublon apparent pouvant être un article volontairement complémentaire) :
add_action( 'manage_posts_custom_column', function ( $colonne, $post_id ) {
    if ( 'titre' !== $colonne ) {
        return;
    }

    $alerte = get_post_meta( $post_id, '_alerte_doublon_possible', true );

    if ( ! empty( $alerte ) ) {
        printf( '<p style="color:#b32d2e;">⚠ Titre proche de %d article(s) existant(s)</p>', count( $alerte ) );
    }
}, 10, 2 );
Pourquoi ne pas bloquer directement la publication
Un blocage automatique serait contre-productif : un dossier thématique qui revient volontairement sur un sujet déjà traité, avec un angle différent, aurait souvent un titre proche du précédent sans qu’il s’agisse d’un doublon problématique. L’alerte informe, la décision reste humaine — c’est le même principe que pour l’indicateur de longueur de titre évoqué ailleurs sur ce site : mieux vaut un signal clair qu’une contrainte rigide qui finit par être contournée.
- Ajustez le seuil de 80 % selon la nature des titres de votre site : des titres courts atteignent plus facilement un pourcentage élevé par hasard.
- Excluez systématiquement les révisions et sauvegardes automatiques du déclenchement, sous peine de comparaisons inutiles à chaque frappe.
- Pensez à purger la meta d’alerte si le rédacteur modifie le titre après coup et que la ressemblance disparaît.
Une règle que j’applique systématiquement sur les sites à plusieurs contributeurs : jamais de blocage automatique sur une simple ressemblance de texte, seulement une alerte visuelle. Le risque de faux positif est trop élevé pour justifier une contrainte stricte.
Le point à retenir
Une fonction native comme similar_text(), sans aucune dépendance externe, permet de couvrir la grande majorité des cas de doublons involontaires sur un site à plusieurs contributeurs. Ce n’est pas une solution de détection sémantique avancée, mais elle règle le problème concret rencontré ici : des rédacteurs qui republient sans le savoir un sujet déjà traité.