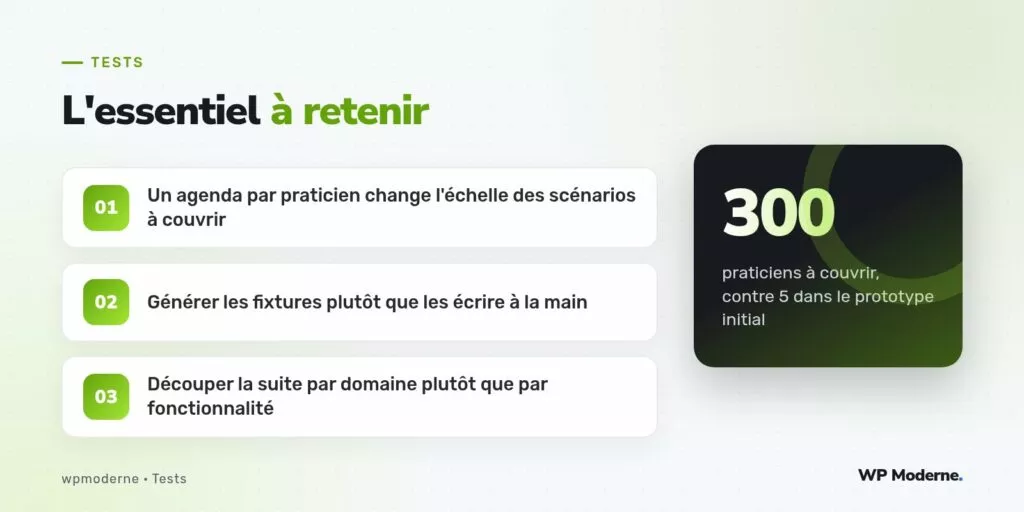
300 praticiens, chacun avec son propre agenda, ses propres règles de disponibilité et ses propres types de rendez-vous : la suite de tests d’intégration héritée du prototype à cinq praticiens ne suffisait plus. Ce projet, un module de prise de rendez-vous médical construit sur WordPress pour un réseau de centres de santé, a servi de terrain à une refonte complète de la stratégie de tests, sans faire exploser le temps d’exécution en CI.
Le défi n’était pas de multiplier les tests par soixante, ce qui aurait rendu la suite ingérable, mais de trouver quels scénarios changent réellement de comportement à cette échelle, et lesquels restent identiques qu’il y ait cinq ou trois cents praticiens. Ce tri a représenté l’essentiel du travail.
Ce qui ne change pas avec l’échelle
La logique de prise d’un rendez-vous individuel — vérifier la disponibilité d’un créneau, appliquer la durée de consultation propre au type d’acte, éviter le chevauchement avec un rendez-vous existant — reste identique quel que soit le nombre de praticiens dans le système. Ces tests unitaires, déjà présents dans le prototype, n’ont pas eu besoin d’être multipliés : un seul praticien de test suffit à les valider.
public function test_creneau_indisponible_si_chevauchement(): void
{
    $praticien = $this->creer_praticien_de_test();
    $this->creer_rendez_vous($praticien, '2026-02-03 09:00', 30);

    $disponible = $this->service_agenda->est_disponible($praticien, '2026-02-03 09:15', 30);

    $this->assertFalse($disponible);
}
Ce qui change réellement à l’échelle
Trois familles de comportements ne se manifestent qu’avec un volume réaliste de praticiens et de rendez-vous simultanés, et méritaient une suite dédiée :
- La recherche de disponibilité multi-praticiens, qui doit filtrer 300 agendas pour proposer les créneaux les plus proches sans dégrader le temps de réponse
- Les règles de remplacement entre praticiens d’un même centre, absentes du prototype à cinq praticiens car jamais nécessaires à cette échelle
- La consolidation des statistiques d’occupation par centre, qui agrège des centaines de milliers de rendez-vous sur une période donnée
Pour la recherche de disponibilité, un test d’intégration avec un jeu de données représentatif s’est révélé indispensable : chercher un créneau libre le lendemain matin, un mardi, avec un filtre sur trois spécialités, dans un centre de cinquante praticiens, ne se comporte pas comme la même recherche sur cinq praticiens.
Générer des fixtures plutôt que les écrire à la main
Écrire manuellement les fixtures de 300 praticiens et de leurs plannings respectifs était hors de question. Une fabrique de données a été construite avec WP_UnitTest_Factory étendue, capable de générer un centre complet avec ses praticiens, leurs horaires types et un historique de rendez-vous cohérent :
class Centre_Medical_Factory extends WP_UnitTest_Factory_For_Thing
{
    public function creer_centre_complet(int $nb_praticiens): array
    {
        $praticiens = [];
        for ($i = 0; $i < $nb_praticiens; $i++) {
            $praticiens[] = $this->creer_praticien_avec_planning_type();
        }
        return $praticiens;
    }
}
Cette fabrique a permis de générer, à la demande, des jeux de données à 5, 50 ou 300 praticiens dans la même suite de tests, en ne conservant les volumes les plus lourds que pour les scénarios qui en ont réellement besoin.
Découper la suite par domaine
Pour éviter qu’une suite d’intégration à grande échelle ne devienne interminable, la découpe s’est faite par domaine métier plutôt que par fonctionnalité technique : un groupe « recherche de disponibilité », un groupe « remplacements », un groupe « statistiques ». Chaque groupe tourne dans son propre job CI, en parallèle des autres, avec ses propres fixtures dédiées.
vendor/bin/phpunit --group=recherche-disponibilite
vendor/bin/phpunit --group=remplacements
vendor/bin/phpunit --group=statistiques
Résultats obtenus
La suite complète, qui aurait dépassé vingt-cinq minutes en exécution séquentielle avec des fixtures à pleine échelle partout, tient en moins de six minutes grâce à cette parallélisation et à l’usage ciblé des gros volumes de données uniquement là où ils changent réellement le comportement testé. Les trois familles de comportements identifiées comme sensibles à l’échelle ont chacune révélé au moins un bug réel lors de la première exécution à volume représentatif, notamment un temps de réponse de la recherche de disponibilité qui dépassait quatre secondes au-delà de cent praticiens actifs simultanément.
Tester à l’échelle ne veut pas dire multiplier chaque test par le facteur de croissance : cela veut dire identifier les quelques comportements qui changent réellement de nature, et concentrer l’effort de fixtures lourdes sur eux seuls.
En résumé
Passer de cinq à trois cents praticiens a exigé de repenser la stratégie de tests, pas seulement son volume : distinguer les scénarios invariants des scénarios sensibles à l’échelle, générer les fixtures plutôt que les écrire, et découper la suite par domaine métier plutôt que par couche technique. Cette approche a permis de couvrir une charge soixante fois supérieure au prototype sans allonger significativement le temps de la CI.