Sur un projet e-commerce de taille moyenne, un test vérifiant la génération d’un export CSV de commandes passait sans problème sur toutes les machines de l’équipe, mais bloquait systématiquement le pipeline GitHub Actions après le délai maximal de dix minutes. Pendant deux jours, les hypothèses les plus exotiques ont circulé — un bug de PHP 8.1 spécifique à l’image Docker utilisée en CI, une régression de PHPUnit — avant qu’un test isolé ne révèle la vraie cause : un appel réseau vers une API de conversion de devises, jamais mocké, qui timeoutait silencieusement dans l’environnement CI dépourvu d’accès sortant à internet.
Ce diagnostic aurait pu être posé bien plus vite avec une méthode systématique, plutôt qu’en suivant les hypothèses les plus spectaculaires en premier.
Symptôme : où s’arrête réellement l’exécution
La première question à se poser n’est pas « pourquoi ça time out » mais « à quel endroit précis ». Activer la sortie détaillée de PHPUnit et observer le dernier test affiché avant le blocage donne une piste immédiate :
phpunit --testdox --verbose 2>&1 | tee ci-output.logSi le blocage survient toujours sur la même méthode, la piste d’une lenteur générale de l’environnement CI (moins de ressources, disque plus lent) s’affaiblit au profit d’une cause spécifique à ce test précis.
Diagnostic 1 — Une dépendance externe non mockée
La cause la plus fréquente, et la plus facile à vérifier : un test qui effectue un vrai appel réseau, une vraie requête vers un service tiers, ou une résolution DNS, se comporte différemment selon que l’environnement dispose ou non d’un accès sortant à internet — souvent restreint ou totalement absent en CI par choix de sécurité :
grep -rn "wp_remote_get\|curl_init\|file_get_contents.*http" tests/Tout résultat renvoyé par cette recherche dans un fichier de test mérite un examen : ces appels doivent être interceptés par un stub ou un mock, jamais exécutés réellement pendant la suite automatisée.
Diagnostic 2 — Un problème de ressources CI
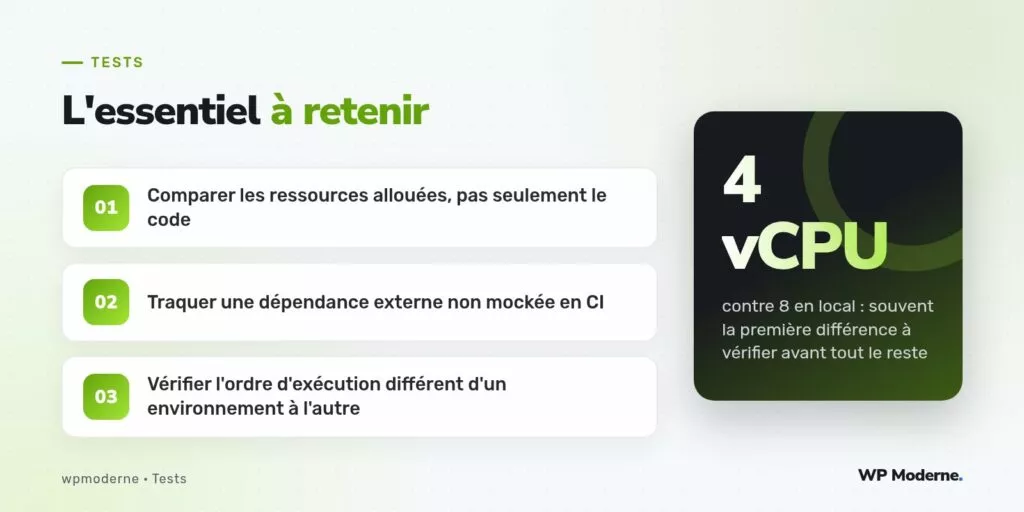
Si le blocage touche plusieurs tests différents sans motif apparent, la piste des ressources devient plus probable : une machine CI virtualisée dispose souvent de moins de mémoire et de CPU qu’un poste de développement, et un test qui génère un gros volume de données en mémoire (une factory qui crée mille articles, par exemple) peut simplement devenir disproportionnellement plus lent, jusqu’à dépasser le délai maximal configuré :
- Vérifier la configuration de mémoire allouée à PHP dans l’image CI (
memory_limit). - Comparer le nombre de cœurs disponibles si la suite parallélise l’exécution des tests.
- Chronométrer isolément le test suspect en local avec une limite de ressources artificiellement réduite, pour reproduire la condition.
Diagnostic 3 — Un ordre d’exécution différent
Certaines configurations CI exécutent les tests dans un ordre différent de celui utilisé en local, notamment lorsque plusieurs fichiers sont répartis entre plusieurs jobs parallèles. Un test qui dépend implicitement d’un état laissé par un autre test — le sujet d’une fuite d’état déjà traité par ailleurs — peut ainsi se comporter normalement en local, où l’ordre est stable, et boucler indéfiniment en CI si l’état attendu n’est jamais initialisé dans le nouvel ordre :
phpunit --order-by=random --random-order-seed=12345Reproduire localement avec une graine aléatoire différente à chaque tentative permet souvent de recréer artificiellement la même situation qu’en CI, sans attendre le prochain pipeline.
Le bon réflexe : une matrice d’élimination, pas une intuition
| Piste | Vérification rapide | Signal si confirmé |
|---|---|---|
| Dépendance externe | Recherche des appels réseau non mockés | Blocage toujours sur le même test |
| Ressources CI | Chronométrage sous contrainte mémoire/CPU réduite | Blocage variable, plusieurs tests concernés |
| Ordre d’exécution | Relance locale en ordre aléatoire | Reproduction intermittente, jamais identique |
Avant de suspecter l’infrastructure CI elle-même, il vaut toujours mieux suspecter d’abord ce que le test fait réellement en coulisses — la plupart des « bugs de CI » sont des bugs de test ordinaires, simplement révélés par un environnement moins tolérant.
Prévention
Une fois la cause identifiée, la prévention est presque toujours la même : mocker systématiquement toute dépendance réseau dans les tests unitaires, réserver les vrais appels externes à une suite d’intégration explicitement isolée et documentée comme telle, et configurer un délai d’exécution maximal par test individuel plutôt qu’un seul délai global pour toute la suite — ce dernier point permet d’obtenir un message d’erreur ciblé au lieu d’un blocage generique de dix minutes qui ne désigne aucun coupable.
En résumé
Un test qui passe en local et bloque en CI n’est presque jamais un problème d’infrastructure exotique. Une dépendance externe oubliée, des ressources plus contraintes, ou un ordre d’exécution différent expliquent la quasi-totalité des cas rencontrés en agence. La méthode d’élimination décrite ici évite de perdre des heures sur de fausses pistes spectaculaires.