Après un incident de production causé par une variable d’environnement mal configurée — le build passait, les tests unitaires passaient, mais l’application plantait au démarrage faute d’une clé de configuration absente du fichier d’exemple versionné — notre équipe a formalisé une checklist explicite de ce qu’un pipeline doit vérifier avant d’autoriser la fusion d’une pull request sur une branche principale. Les tests unitaires, aussi solides soient-ils, ne couvrent qu’une partie du risque réel.
Cette checklist n’est pas figée dans le marbre : elle s’adapte à chaque projet, mais son ossature reste commune à la plupart de nos chantiers WordPress d’agence.
1. Les tests automatisés, sans exception de branche
Le socle attendu : suite PHPUnit, suite Jest si des blocs ou des scripts sont concernés, et tests d’acceptation si le projet en dispose. Aucune de ces étapes ne doit pouvoir être ignorée par un [skip ci] laissé sur une branche destinée à la production.
2. Le linting de style, bloquant et non simplement informatif
Un rapport PHPCS ou ESLint qui se contente d’un avertissement dans les logs, sans faire échouer le pipeline, finit toujours par être ignoré au bout de quelques semaines. Le linting doit produire un code de sortie non nul en cas de violation des règles définies pour le projet :
vendor/bin/phpcs --standard=WordPress --error-severity=1 --warning-severity=8 src/
npx eslint src/ --max-warnings=0
3. Le build, exécuté dans les mêmes conditions qu’en production
Un build qui fonctionne uniquement en local, avec des dépendances de développement absentes du pipeline, ne prouve rien sur ce qui sera réellement déployé. Le pipeline doit reproduire une installation propre, sans cache local, avant de lancer la compilation des assets :
rm -rf node_modules vendor
composer install --no-dev --optimize-autoloader
npm ci
npm run build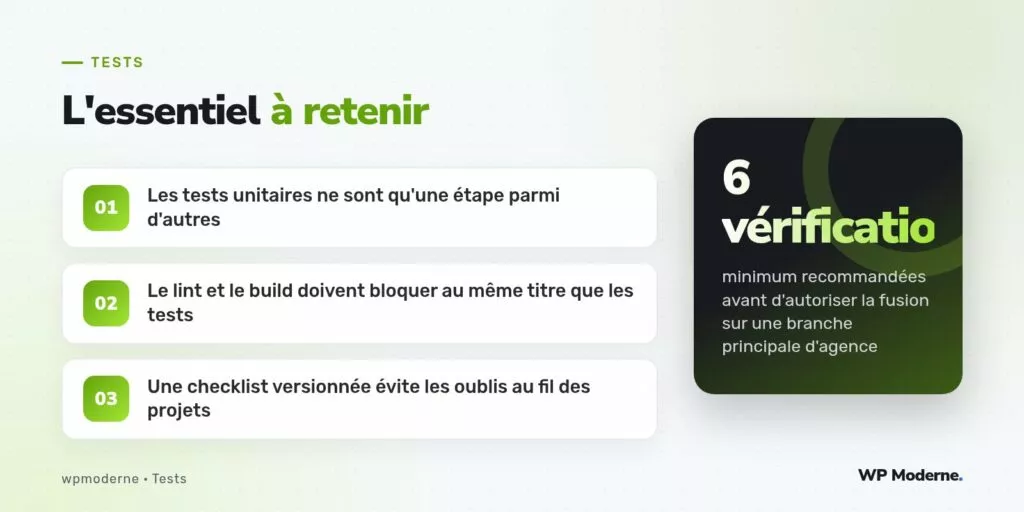
4. L’analyse statique, séparée du linting de style
PHPStan ou Psalm détectent une classe d’erreurs différente du style de code : des incohérences de type, des appels à des méthodes inexistantes, des variables potentiellement non définies. Cette étape mérite sa propre place dans la checklist, distincte du simple linting, avec un niveau de rigueur défini explicitement pour le projet plutôt que le niveau maximal par défaut, souvent trop strict pour une base de code existante.
5. Une vérification de sécurité de base
- Scanner les dépendances Composer et npm à la recherche de vulnérabilités connues (
composer audit,npm audit). - Vérifier qu’aucun secret (clé API, mot de passe) n’a été committé par erreur, via un outil de détection de secrets dans les diffs.
- S’assurer qu’aucune fonction dangereuse (
eval,extractsur une entrée utilisateur non filtrée) n’a été introduite, via une règle de lint dédiée.
6. La cohérence de la configuration entre les environnements
C’est précisément l’étape qui manquait lors de l’incident évoqué en introduction. Un script simple compare les clés présentes dans le fichier d’exemple versionné (.env.example) à celles réellement utilisées dans le code, pour repérer une variable oubliée avant qu’elle ne cause un incident en production :
#!/usr/bin/env bash
set -euo pipefail

grep -oP "getenv\('\K[A-Z_]+" src/ -r | sort -u > /tmp/variables-utilisees.txt
grep -oP "^[A-Z_]+(?==)" .env.example | sort -u > /tmp/variables-declarees.txt

comm -23 /tmp/variables-utilisees.txt /tmp/variables-declarees.txt > /tmp/manquantes.txt

if [ -s /tmp/manquantes.txt ]; then
  echo "Variables utilisées mais absentes de .env.example :"
  cat /tmp/manquantes.txt
  exit 1
fi
Un pipeline qui ne bloque que sur les tests unitaires protège contre les régressions de comportement, mais laisse passer toutes les régressions d’infrastructure — configuration, dépendances, style — qui causent, dans notre expérience d’agence, au moins autant d’incidents en production.
Ce que cette checklist ne remplace pas
Ces six vérifications automatisées ne dispensent jamais d’une revue de code humaine sur la logique métier et l’architecture des changements proposés — l’organisation de cette revue humaine, qui l’effectue et selon quels critères, relève d’un sujet distinct déjà traité par ailleurs, indépendant de l’outillage du pipeline lui-même.
Adapter la checklist sans la diluer
Ajouter une septième ou huitième vérification est toujours tentant, mais chaque étape supplémentaire ralentit le retour d’information aux développeurs. La règle que nous appliquons : une nouvelle vérification n’entre dans la checklist qu’après avoir causé, au moins une fois, un incident qu’elle aurait empêché — jamais par simple prudence théorique.
Pour aller plus loin
Versionner cette checklist directement dans le dépôt, sous forme de configuration de pipeline plutôt que de document externe, garantit qu’elle évolue avec le projet et reste appliquée de façon identique par tous les contributeurs, sans dépendre de la mémoire individuelle de chacun.