Une agence de développement gérant 47 sites clients sous WordPress nous a exposé un problème récurrent : une mise à jour de thème ou de plugin cassait silencieusement le balisage Schema.org d’un ou plusieurs sites, sans que personne ne s’en aperçoive avant plusieurs semaines, au moment d’un contrôle manuel de routine ou d’une alerte tardive dans la Search Console.
La solution retenue consiste à intégrer un contrôle automatique des données structurées directement dans le pipeline d’intégration continue, de façon à bloquer un déploiement suspect avant qu’il n’atteigne la production.
Étape 1 : choisir un outil de validation exécutable en ligne de commande
Contrairement à l’outil de test des résultats enrichis de Google, pensé pour un contrôle manuel ponctuel via navigateur, l’automatisation demande un outil scriptable. Le paquet npm structured-data-testing-tool permet de valider un jeu de schémas contre une URL ou un fichier HTML directement en ligne de commande, avec un code de sortie exploitable par un pipeline.
npm install --save-dev structured-data-testing-tool
Étape 2 : définir les schémas attendus par type de page
Chaque type de page du site a ses propres attentes : un article doit exposer un schéma Article complet, une page produit un schéma Product avec prix et disponibilité, une page FAQ un schéma FAQPage. Ces attentes se déclarent dans un fichier de configuration dédié au projet :
module.exports = {
  presets: [ 'google' ],
  tests: [ 'Article', 'BreadcrumbList' ],
  urls: [
    'https://exemple-client.fr/article-test/',
    'https://exemple-client.fr/'
  ]
};
Étape 3 : intégrer le contrôle dans le pipeline GitHub Actions
Le contrôle s’exécute après chaque déploiement sur un environnement de recette, avant toute promotion vers la production :
name: Verification donnees structurees
on:
  push:
    branches: [ recette ]
jobs:
  structured-data:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-node@v4
        with:
          node-version: '20'
      - run: npm install
      - run: npx sdtt --url https://recette.exemple-client.fr/article-test/ --presets google
Un code de sortie différent de zéro sur cette dernière commande interrompt automatiquement le pipeline, empêchant la mise en production tant que le balisage n’a pas été corrigé.
Étape 4 : compléter avec un contrôle de syntaxe JSON-LD pur
Au-delà de la présence des bonnes propriétés, une vérification de la validité syntaxique du JSON-LD généré évite les erreurs de parenthésage ou d’échappement introduites par un développeur pressé. Un script simple, exécuté sur le HTML brut de la page, extrait chaque bloc <script type="application/ld+json"> et tente un JSON.parse() :
const cheerio = require('cheerio');
const html = await (await fetch(url)).text();
const $ = cheerio.load(html);
$('script[type="application/ld+json"]').each((i, el) => {
  try {
    JSON.parse($(el).html());
  } catch (e) {
    console.error(`JSON-LD invalide sur le bloc ${i}: ${e.message}`);
    process.exitCode = 1;
  }
});
Étape 5 : gérer les faux positifs sans désactiver le contrôle
Certains sites clients utilisent des schémas légitimement incomplets sur des pages spécifiques (une page d’atterrissage sans auteur identifié, par exemple). Plutôt que de désactiver le contrôle sur ces exceptions, l’agence maintient une liste blanche explicite d’URL exclues, documentée dans le fichier de configuration, pour éviter qu’une exception ponctuelle ne masque une vraie régression ailleurs.
Résultat après six mois d’utilisation
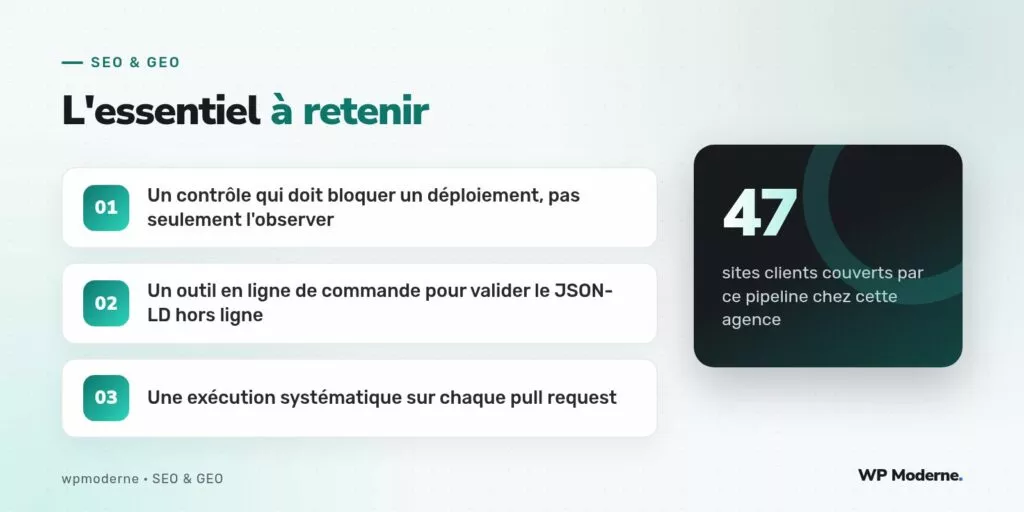
Sur les 47 sites couverts par ce pipeline, trois régressions de balisage ont été détectées et bloquées avant mise en production, contre une moyenne historique de six à huit incidents détectés tardivement par an avant la mise en place de ce contrôle.
Un contrôle qui se contente d’alerter finit toujours par être ignoré. Un contrôle qui bloque le déploiement reste le seul qui tienne dans la durée.
En résumé
Automatiser la validation des données structurées en intégration continue transforme un contrôle qualité auparavant manuel et sporadique en un filet de sécurité systématique. Pour une agence gérant un parc de sites conséquent, ce type de pipeline change concrètement la vitesse de détection d’une régression, la faisant passer de plusieurs semaines à quelques minutes après chaque déploiement.