« Combien de pages faut-il réellement migrer, et sous quelle forme ? » C’est la première question à trancher avant d’ouvrir le moindre éditeur, lorsqu’une chambre d’agriculture décide de quitter sa plateforme institutionnelle historique pour WordPress. Ce billet détaille les étapes de cartographie et de migration technique. Il ne traite pas la formation des agents à la prise en main du nouvel outil, sujet distinct traité séparément par l’équipe projet.
La plateforme d’origine, développée sur mesure des années auparavant, organisait ses contenus en catégories rigides : actualités réglementaires, fiches techniques par filière, annuaire des exploitants accompagnés, et pages d’information générale. Chacune de ces catégories avait sa propre logique d’URL, souvent héritée de choix techniques anciens et jamais harmonisée.
Étape 1 : cartographier l’existant avant tout code
Avant d’écrire la moindre ligne de migration, un inventaire complet des contenus existants a été établi, avec pour chaque page son URL actuelle, son type de contenu apparent, sa dernière date de mise à jour et son volume de trafic organique sur les douze derniers mois. Cet inventaire, réalisé à partir d’un export du plan du site existant croisé avec les données de la Search Console, a permis d’identifier plus de 900 pages à traiter, réparties en cinq grandes familles de contenu.
Cette étape révèle systématiquement des surprises : des pages oubliées mais qui reçoivent encore un trafic non négligeable, des doublons issus de refontes partielles antérieures, ou des URL qui redirigeaient déjà vers d’autres adresses sans que personne ne s’en souvienne.
Étape 2 : concevoir des types de contenu personnalisés fidèles
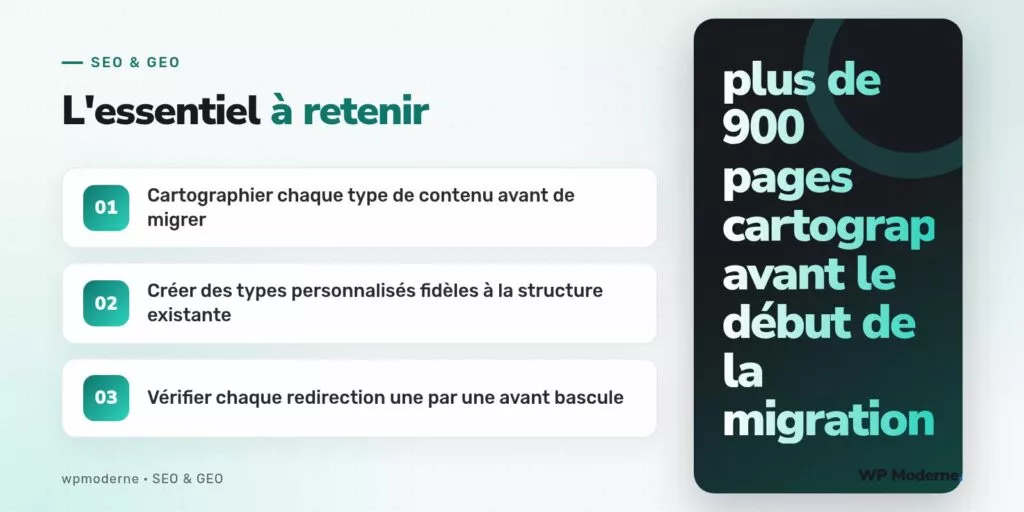
Plutôt que de tout regrouper dans des articles de blog classiques, la structure retenue introduit des types de contenu personnalisés correspondant aux familles identifiées lors de l’inventaire : fiche_technique pour les contenus par filière agricole, actualite_reglementaire pour les publications à caractère normatif, et exploitant_accompagne pour l’annuaire, chacun enregistré via register_post_type() avec ses propres champs et son propre gabarit d’affichage.
register_post_type( 'fiche_technique', array(
    'labels'       => array( 'name' => 'Fiches techniques' ),
    'public'       => true,
    'has_archive'  => true,
    'rewrite'      => array( 'slug' => 'fiches-techniques' ),
    'supports'     => array( 'title', 'editor', 'custom-fields' ),
    'show_in_rest' => true,
) );
Ce choix conserve la logique de navigation à laquelle les visiteurs réguliers, souvent des exploitants agricoles habitués à chercher une fiche par filière, étaient déjà accoutumés, plutôt que de tout aplatir dans une structure générique qui aurait perdu ce repère.
Étape 3 : construire le tableau de correspondance des URL
Chaque ancienne URL identifiée lors de l’inventaire a été associée à sa nouvelle adresse dans un tableau de correspondance, tenu à jour tout au long du projet dans un tableur partagé avant d’être converti en règles de redirection. Cette étape, fastidieuse mais non négociable, a représenté la part la plus longue du travail de migration.
- Extraction de la liste complète des URL depuis l’ancienne plateforme et les journaux serveur des six derniers mois.
- Association de chaque URL à son type de contenu personnalisé cible et à sa nouvelle adresse.
- Identification des URL sans contenu de remplacement direct, orientées vers la page de catégorie la plus proche plutôt que vers une redirection artificielle sans rapport.
- Conversion du tableau en règles de réécriture, intégrées au fichier
.htaccessdu nouvel hébergement.
Étape 4 : vérifier chaque redirection avant la bascule définitive
Une fois les règles de redirection écrites, chaque adresse du tableau a été testée individuellement sur l’environnement de préproduction, avec un contrôle du code de statut HTTP retourné et de la destination réelle atteinte. Cette vérification manuelle, bien que consommatrice de temps sur plusieurs centaines d’URL, a permis de repérer une quinzaine d’erreurs de correspondance avant qu’elles n’affectent le site en production.
Étape 5 : suivre la période post-bascule
Dans les semaines suivant la bascule, la couverture d’indexation dans la Search Console a été suivie de près, avec une attention particulière portée aux erreurs 404 remontées, chacune vérifiée pour déterminer si une redirection avait été oubliée dans le tableau de correspondance initial.
En résumé
Migrer une institution comme une chambre d’agriculture vers WordPress sans perdre l’autorité acquise sur des années repose moins sur la technologie choisie que sur la rigueur de la cartographie préalable et le soin apporté à chaque redirection. Un inventaire incomplet ou un tableau de correspondance approximatif se paie toujours plus cher après la bascule qu’avant, sous forme de trafic perdu difficile à récupérer.