Un client éditeur de fiches pratiques juridiques nous a posé une question inhabituelle en début d’année : plutôt que d’espérer être bien crawlé, pouvait-on donner directement à un agent IA un accès propre et structuré à son contenu ? Le Model Context Protocol (MCP), popularisé depuis fin 2024, offre exactement ce type de pont. Voici comment un serveur MCP en lecture seule a été construit au-dessus de ce site WordPress, étape par étape, sans aborder ici la question de l’écriture par l’agent, volontairement laissée de côté sur ce projet.
Étape 1 : choisir ce qui doit être exposé
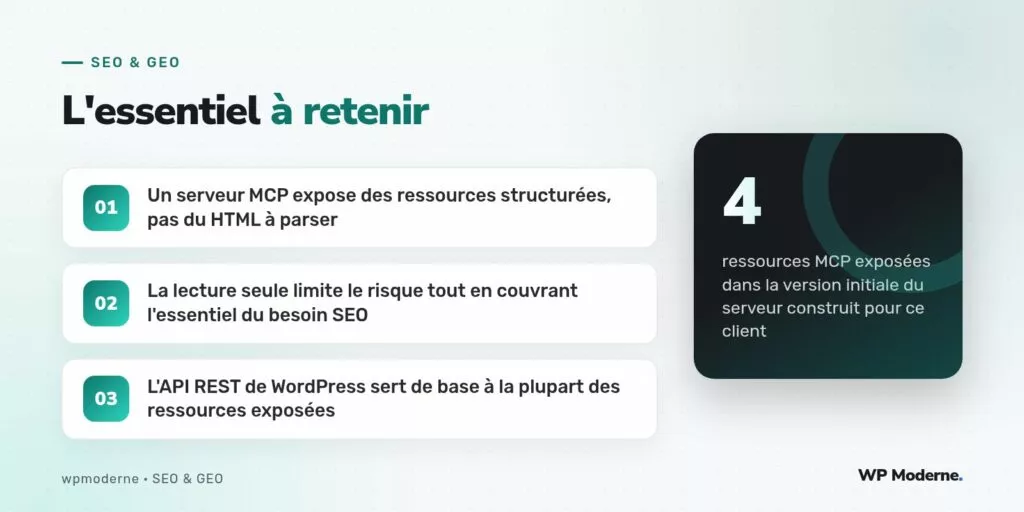
Avant d’écrire une ligne de code, la première décision a porté sur le périmètre. Exposer l’intégralité du site aurait été inutilement risqué et coûteux à maintenir. Le choix s’est porté sur quatre ressources précises, correspondant aux besoins réels identifiés avec le client : la liste des fiches par thème juridique, le contenu détaillé d’une fiche donnée, les mises à jour réglementaires récentes, et un outil de recherche par mot-clé dans le corpus.
Étape 2 : s’appuyer sur l’API REST existante
Plutôt que de réinventer un accès aux données, le serveur MCP s’appuie sur l’API REST déjà exposée nativement par WordPress. Chaque ressource MCP correspond à un appel filtré vers cette API :
const express = require('express');
const { McpServer } = require('@modelcontextprotocol/sdk/server/mcp.js');

const server = new McpServer({ name: 'fiches-juridiques', version: '1.0.0' });

server.resource('fiches-par-theme', 'fiches://theme/{theme}', async (uri, { theme }) => {
  const reponse = await fetch(
    `https://exemple-client.fr/wp-json/wp/v2/posts?categories_slug=${theme}&per;_page=50`
  );
  const articles = await reponse.json();
  return {
    contents: articles.map((a) => ({
      uri: `fiches://article/${a.id}`,
      text: `${a.title.rendered} — ${a.excerpt.rendered}`
    }))
  };
});
Étape 3 : garder le serveur strictement en lecture seule
Aucune méthode exposée ne permet de créer, modifier ou supprimer du contenu. Le serveur ne déclare que des resources et un seul tool de recherche en lecture, jamais de méthode capable d’écrire en base. Ce choix, discuté avec le client, répond à une logique simple : couvrir le besoin réel (donner un accès fiable au contenu) sans ouvrir de surface d’attaque inutile sur un site qui gère des informations juridiques sensibles.
server.tool('rechercher-fiches', {
  motCle: z.string().describe('Terme à rechercher dans les fiches juridiques')
}, async ({ motCle }) => {
  const reponse = await fetch(
    `https://exemple-client.fr/wp-json/wp/v2/posts?search=${encodeURIComponent(motCle)}`
  );
  const resultats = await reponse.json();
  return {
    content: [{ type: 'text', text: JSON.stringify(resultats.map(r => r.title.rendered)) }]
  };
});
Étape 4 : authentification et journalisation
Le serveur exige un jeton d’accès pour chaque connexion, distribué aux partenaires autorisés à consommer ces données, et journalise chaque appel avec l’identifiant du client et la ressource demandée. Cette journalisation sert un double objectif : détecter un usage anormal, et alimenter un suivi statistique de quelles fiches sont le plus souvent interrogées par les agents connectés, un signal complémentaire aux données classiques de trafic.
Étape 5 : ce que ça change pour le SEO
Contrairement à un crawl HTML classique, qui doit deviner la structure d’une page pour en extraire l’information utile, un agent connecté au serveur MCP reçoit une donnée déjà propre et typée : un titre, un extrait, une date, sans avoir à interpréter un balisage HTML parfois ambigu. Pour ce client, l’intérêt principal n’est pas de remplacer l’indexation classique, mais d’offrir un canal fiable aux partenaires qui construisent des services d’assistance juridique automatisée s’appuyant sur ce contenu.
| Ressource exposée | Équivalent REST WordPress sous-jacent |
|---|---|
| fiches-par-theme | /wp/v2/posts?categories_slug=... |
| fiche-detail | /wp/v2/posts/{id} |
| mises-a-jour-recentes | /wp/v2/posts?orderby=modified |
Un principe qu’on a posé dès le départ avec ce client : un serveur MCP n’est utile que s’il reste plus fiable qu’un scraping HTML. Le jour où il devient une source d’incohérence, il vaut mieux le couper.
En résumé
Construire un serveur MCP en lecture seule au-dessus d’un site WordPress reste un chantier raisonnable quand le périmètre exposé est limité et clairement défini en amont. Sur ce projet, quatre ressources bien choisies ont suffi à répondre au besoin réel des partenaires, sans qu’il soit nécessaire d’ouvrir la moindre capacité d’écriture pour obtenir ce résultat.