Une plateforme SaaS construite sur WordPress héberge des espaces de gestion de projet pour plusieurs cabinets de conseil indépendants, chacun avec ses propres dossiers clients stockés comme un type de contenu personnalisé dossier_client. Chaque cabinet ne doit voir que ses propres dossiers, jamais ceux des autres, alors que tous partagent la même base de données WordPress pour des raisons de coûts d’infrastructure — une architecture multi-tenant à un seul niveau de base, plus économique qu’une instance séparée par client mais qui exige une rigueur absolue dans le filtrage des données.
La première version de cette isolation reposait uniquement sur des vérifications de capacité côté PHP : chaque écran vérifiait current_user_can() avant d’afficher un dossier. Cette approche fonctionne pour empêcher un affichage non autorisé, mais elle ne protège en rien contre une requête personnalisée ailleurs dans le code (un export, un rapport, une extension tierce) qui interrogerait directement WP_Query ou $wpdb sans repasser par cette vérification. Un audit a confirmé le risque : un module de reporting statistique, ajouté plus tard par un autre développeur, agrégeait les dossiers de tous les cabinets sans le vouloir, simplement parce qu’il n’avait aucune raison de connaître la logique de vérification utilisée ailleurs.
Pourquoi filtrer au niveau de la requête plutôt qu’à l’affichage
La vérification de capacité protège une action ou un affichage précis, mais elle est aussi fragile que la discipline de chaque développeur qui écrit du code sur le projet : il suffit d’un oubli, une seule fois, dans un seul module, pour qu’une fuite de données entre cabinets se produise. Une protection plus robuste consiste à empêcher structurellement qu’une requête retourne des données hors périmètre, quel que soit l’endroit du code qui l’exécute — un principe proche du concept de row-level security que l’on trouve nativement dans certains systèmes de gestion de base de données, mais que WordPress ne propose pas par défaut : il faut le construire soi-même via ses points d’extension SQL.
Filtrer avec posts_where
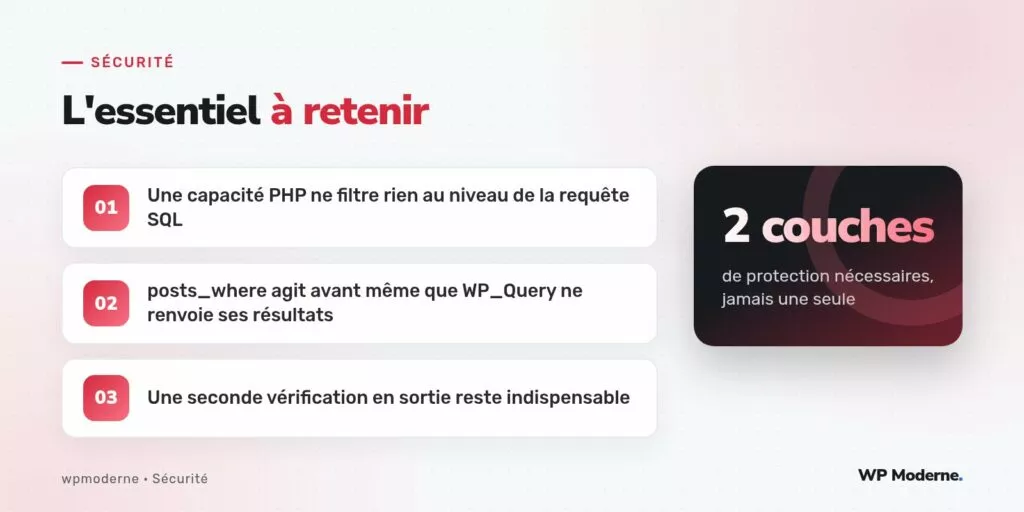
Le filtre posts_where s’exécute lors de la construction de la clause SQL WHERE de toute requête passant par WP_Query, y compris celles générées en interne par WordPress pour l’affichage standard. En y ajoutant une condition supplémentaire basée sur le cabinet de l’utilisateur courant, chaque requête sur le type de contenu concerné se retrouve automatiquement restreinte, sans dépendre de la mémoire du développeur qui écrit la requête :
add_filter( 'posts_where', 'moncpt_filtrer_dossiers_par_cabinet', 10, 2 );

function moncpt_filtrer_dossiers_par_cabinet( $where, $query ) {
    global $wpdb;

    // On ne touche qu'aux requêtes concernant le type de contenu sensible,
    // pour ne jamais affecter le reste du site par effet de bord.
    if ( 'dossier_client' !== $query->get( 'post_type' ) ) {
        return $where;
    }

    $utilisateur = wp_get_current_user();

    // Un super administrateur technique garde un accès complet, pour la
    // maintenance ; ce cas doit rester exceptionnel et journalisé.
    if ( user_can( $utilisateur, 'manage_network' ) ) {
        return $where;
    }

    $cabinet_id = (int) get_user_meta( $utilisateur->ID, 'cabinet_id', true );

    if ( ! $cabinet_id ) {
        // Aucun cabinet identifié : on ne prend aucun risque, on ne renvoie rien.
        return $where . ' AND 1 = 0';
    }

    $where .= $wpdb->prepare(
        " AND {$wpdb->posts}.ID IN (
            SELECT post_id FROM {$wpdb->postmeta}
            WHERE meta_key = 'cabinet_id' AND meta_value = %d
        )",
        $cabinet_id
    );

    return $where;
}
Ce filtre s’applique à toute requête WP_Query qui cible dossier_client, qu’elle soit écrite dans l’écran principal de gestion des dossiers ou, comme c’était le cas ici, dans un module de reporting ajouté ultérieurement sans connaissance du contexte multi-tenant du projet.
Les limites de posts_where à connaître
Ce filtre ne couvre que les requêtes qui passent réellement par WP_Query. Une requête $wpdb->get_results() écrite directement en SQL brut, sans passer par l’API de requêtage de WordPress, contourne entièrement ce filtre — c’est d’ailleurs précisément ce que faisait le module de reporting fautif dans sa version initiale, ce qui a nécessité une seconde correction pour le faire passer par WP_Query plutôt que par une requête directe, afin de bénéficier de cette protection centralisée.
Le filtre posts_where constitue donc une couche de protection puissante mais pas universelle : il doit être complété par une revue de code systématique de toute requête $wpdb écrite manuellement sur ce type de contenu, pour s’assurer qu’elle applique elle aussi la même condition de filtrage par cabinet, de façon explicite.
Deux couches, jamais une seule
La conclusion opérationnelle de cet audit tient en un principe simple : le filtrage au niveau de la requête (par posts_where ou équivalent) protège contre l’oubli d’une vérification métier ailleurs dans le code, mais ne dispense jamais de garder les vérifications de capacité à l’affichage. Ce sont deux couches indépendantes, avec des rôles différents — l’une empêche une fuite de données au niveau structurel, l’autre empêche une action non autorisée au niveau fonctionnel — et aucune des deux ne remplace l’autre.
Sur ce projet, la règle adoptée après l’audit a été formalisée ainsi : toute nouvelle requête sur un type de contenu sensible au multi-tenant doit obligatoirement passer par
WP_Query, jamais par un appel$wpdbdirect, précisément pour bénéficier automatiquement du filtre centralisé.
Pour aller plus loin
Ce sujet ne détaille pas le fonctionnement général de current_user_can() et de ses capacités, déjà traité par ailleurs. Il complète cette base en montrant qu’une vérification de capacité, aussi correcte soit-elle, protège un point d’entrée précis mais jamais l’intégralité des chemins possibles vers une même donnée — d’où la nécessité d’un filtrage structurel en complément dans tout contexte multi-tenant.