Un réseau multisite regroupe les sites de plusieurs éditions d’un même festival de musique : une entrée par édition annuelle, chacune avec sa programmation, sa billetterie et ses partenaires. Un tableau de bord central, développé en interne, agrège pour l’équipe de direction les chiffres de fréquentation de chaque édition sur une même page. Ce tableau de bord, qui répondait en une fraction de seconde à son lancement, mettait plusieurs secondes à s’afficher au bout de quelques semaines d’utilisation intensive.
Le symptôme précis : plus l’équipe naviguait dans les différents onglets du tableau de bord au cours d’une même session, plus chaque clic devenait lent, jusqu’à un ralentissement franchement gênant après une dizaine d’actions.
Diagnostic : une pile qui ne se vide jamais
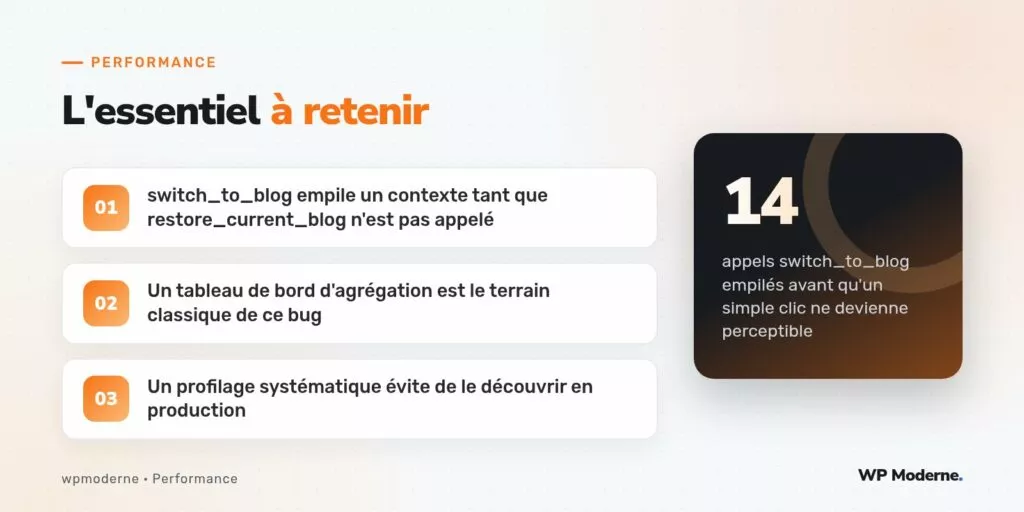
Le tableau de bord parcourait la liste des éditions avec get_sites(), puis appelait switch_to_blog( $site_id ) pour chaque édition afin de lire ses statistiques locales via get_option() et des requêtes personnalisées. Le problème : plusieurs chemins de code sortaient de la boucle par un return anticipé, en cas de site invalide ou de permission insuffisante, sans jamais appeler restore_current_blog() avant de sortir.
Résultat : la pile interne de sites gérée par $GLOBALS['_wp_switched_stack'] s’accumulait au fil des requêtes du même processus PHP-FPM, dans les environnements où ce processus restait actif entre deux requêtes similaires. Chaque nouvel appel à switch_to_blog() partait d’un contexte déjà empilé plusieurs fois, et chaque restauration ultérieure devait dépiler des couches inutiles, ralentissant les fonctions dépendant du contexte de site courant.
Le correctif : fermer systématiquement ce qu’on ouvre
La règle appliquée a été simple et non négociable : tout switch_to_blog() doit avoir son restore_current_blog() correspondant, y compris sur les sorties anticipées :
foreach ( $editions as $site ) {
    switch_to_blog( $site->blog_id );

    if ( ! festival_edition_est_valide() ) {
        restore_current_blog(); // sortie anticipée : ne pas oublier
        continue;
    }

    $stats[ $site->blog_id ] = festival_lire_statistiques();

    restore_current_blog();
}
Une alternative plus robuste, adoptée par la suite, a consisté à encapsuler la logique dans une fonction dédiée avec un bloc try/finally, garantissant l’appel à restore_current_blog() même en cas d’exception levée par le code métier entre les deux appels.
Prévention : profiler systématiquement les tableaux de bord multisites
Ce type de bug ne se voit pas à la lecture rapide du code : il faut soit dérouler mentalement chaque chemin de sortie de boucle, soit s’appuyer sur un outil de profilage qui affiche la pile de sites active à un instant donné. Un contrôle ajouté en fin de requête, dans un environnement de développement, aide à repérer l’anomalie avant qu’elle n’atteigne la production.
- Vérifier après chaque requête que
$GLOBALS['_wp_switched_stack']est bien vide. - Faire relire tout code parcourant plusieurs sites par une deuxième personne, en se concentrant uniquement sur les sorties de boucle.
- Préférer une fonction utilitaire encapsulant systématiquement l’appariement
switch_to_blog()/restore_current_blog().
Ce que ce correctif ne traite pas
La question du cache d’objets partagé ou non entre les sites d’un même réseau est un sujet distinct, avec ses propres arbitrages selon que les statistiques doivent ou non être isolées par édition. Elle mérite un traitement à part et n’est pas abordée ici.
Une boucle sur plusieurs sites qui ralentit progressivement, jamais dès le premier appel, pointe presque toujours vers un contexte qui ne se referme pas.
En résumé
Le ralentissement d’un tableau de bord multisite qui s’aggrave au fil d’une session porte souvent la signature d’un switch_to_blog() jamais rééquilibré par un restore_current_blog(). La correction est mécanique une fois le diagnostic posé, mais elle exige une discipline de code stricte sur chaque chemin de sortie, y compris ceux qu’on écrit en pensant qu’ils ne se produiront « presque jamais ».