Le site est celui d’un média régional dont le trafic peut être multiplié par huit en quelques minutes lors d’un événement local majeur (intempéries, actualité chaude), avec des pointes qui saturent systématiquement le serveur MySQL principal bien avant que PHP-FPM ne montre le moindre signe de fatigue. L’analyse de charge a montré que la quasi-totalité des requêtes pendant ces pics sont des lectures (affichage d’articles, de listes, de recherches), et qu’une part infime seulement correspond à des écritures (commentaires, connexions, actions d’administration).
L’architecture retenue exploite cette asymétrie : rediriger l’essentiel des lectures vers une ou plusieurs répliques MySQL en lecture seule, tout en gardant les écritures sur le serveur principal, sans que cela ne demande de réécrire les requêtes métier du site.
Pourquoi HyperDB plutôt qu’une solution maison
Réécrire chaque appel à $wpdb pour choisir explicitement la bonne connexion selon qu’il s’agit d’une lecture ou d’une écriture représenterait un chantier disproportionné sur un site avec des années de code existant, extensions tierces comprises. HyperDB, le drop-in officiel proposé par WordPress.com et maintenu sur le dépôt GitHub d’Automattic, remplace la classe wpdb standard par une version capable de router automatiquement les requêtes selon leur nature (SELECT contre INSERT, UPDATE, DELETE), sans modification du code appelant.
Architecture générale
┌─────────────────────────┐
│   Visiteurs (lecture)   │
└───────────┬─────────────┘
            │
            ▼
   ┌──────────────────┐        charge > seuil       ┌──────────────────────┐
   │  Load balancer /  │ ───────────────────────────▶│  Réplique MySQL #1    │
   │  routage HyperDB  │                              │  (lecture seule)      │
   └─────────┬─────────┘                              └──────────────────────┘
             │  charge normale, écritures                        ▲
             ▼                                                   │ réplication
   ┌──────────────────────┐   flux binlog (asynchrone)          │
   │  MySQL principal      │──────────────────────────────────────┘
   │  (lecture + écriture) │
   └──────────────────────┘
La configuration db-config.php
HyperDB se configure via un fichier db-config.php placé dans wp-content, qui déclare les différents serveurs disponibles et leur rôle. Le fichier ci-dessous illustre une configuration à deux répliques, avec bascule automatique si l’une d’elles ne répond pas.
<?php
$wpdb->add_database( [
    'host'     => DB_HOST_PRINCIPAL,
    'user'     => DB_USER,
    'password' => DB_PASSWORD,
    'name'     => DB_NAME,
    'write'    => 1,
    'read'     => 1,
    'dataset'  => 'global',
] );

$wpdb->add_database( [
    'host'     => DB_HOST_REPLIQUE_1,
    'user'     => DB_USER_LECTURE,
    'password' => DB_PASSWORD_LECTURE,
    'name'     => DB_NAME,
    'write'    => 0,
    'read'     => 2,
    'dataset'  => 'global',
] );

$wpdb->add_database( [
    'host'     => DB_HOST_REPLIQUE_2,
    'user'     => DB_USER_LECTURE,
    'password' => DB_PASSWORD_LECTURE,
    'name'     => DB_NAME,
    'write'    => 0,
    'read'     => 2,
    'dataset'  => 'global',
] );
Le seuil de basculement
Plutôt que de router systématiquement toutes les lectures vers les répliques en permanence, ce qui exposerait le site en continu au délai de réplication, l’équipe a choisi de ne router les lectures les moins critiques vers les répliques qu’au-delà d’un seuil de charge sur le serveur principal, surveillé via une métrique simple exposée par un script de supervision et exploitée par le paramètre de priorité (read) d’HyperDB, ajusté dynamiquement par un petit script cron qui réécrit la configuration selon la charge observée.
Ce qui reste toujours sur le serveur principal
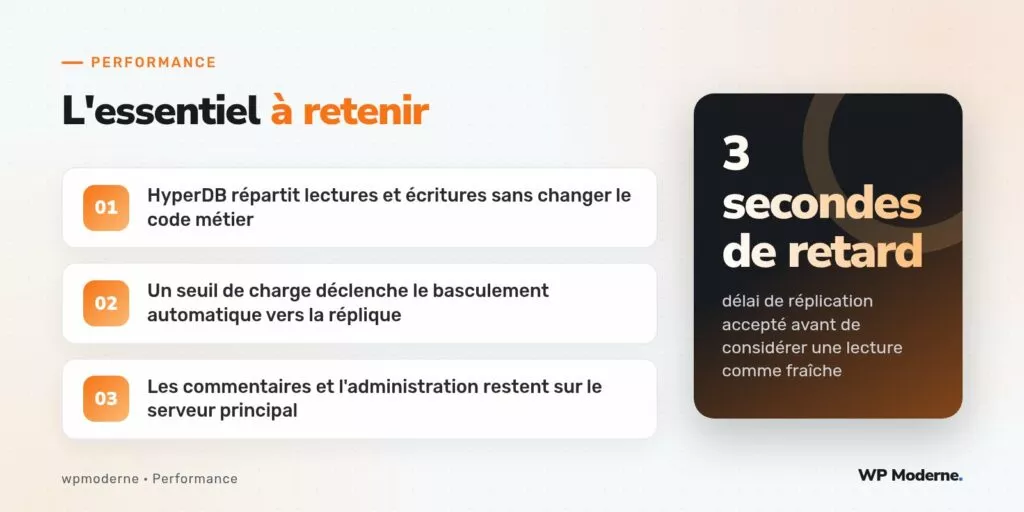
- Toutes les écritures : nouveaux articles, commentaires, connexions.
- Les lectures immédiatement suivies d’une écriture dans le même cycle de requête (pour éviter de lire une donnée pas encore répliquée).
- L’ensemble de l’espace d’administration, par prudence, même en lecture seule.
Le compromis de la cohérence éventuelle
La réplication MySQL classique est asynchrone : une écriture sur le serveur principal met un court instant à apparaître sur les répliques, de l’ordre de quelques centaines de millisecondes en fonctionnement normal mais qui peut monter à plusieurs secondes en cas de pic d’écriture soutenu. L’équipe a fixé une tolérance de trois secondes de retard de réplication au-delà de laquelle une réplique est temporairement retirée du pool de lecture par le script de supervision, pour éviter de servir des contenus visiblement obsolètes (un article tout juste publié qui n’apparaîtrait pas encore dans les listes, par exemple).
Une réplique en retard qu’on continue d’interroger coûte plus cher en confiance qu’une réplique temporairement écartée du pool.
Hors périmètre de cette architecture
Cet article ne traite pas la mise en place de la réplication MySQL elle-même côté administration système (configuration du binlog, création des comptes de réplication, supervision de la latence au niveau serveur), qui relève d’un chantier d’infrastructure distinct et préalable à toute intégration HyperDB côté application.
En résumé
Le routage automatique des lectures vers des répliques MySQL au-delà d’un seuil de charge a permis d’absorber des pics de trafic multipliés par huit sans dégradation perceptible du temps de réponse, en acceptant un compromis de fraîcheur mesuré et surveillé plutôt qu’une cohérence stricte à tout prix. L’essentiel de la complexité ne réside pas dans HyperDB lui-même, dont la configuration reste directe, mais dans la définition du bon seuil de bascule et de la bonne tolérance de retard de réplication.