Vingt-six secondes : c’était le temps nécessaire pour générer un document de synthèse patrimoniale de quarante pages, destiné aux clients d’un office notarial depuis un espace client sécurisé construit sur WordPress. Ce délai, jugé inacceptable par l’équipe, a motivé un audit de performance ciblé sur cette seule fonctionnalité.
Le document combinait plusieurs sections générées dynamiquement à partir de données stockées en métadonnées personnalisées : biens immobiliers, participations, historique de transactions. Le rendu final passait par une extension de génération PDF côté serveur, invoquée après assemblage du contenu HTML source.
Première étape : isoler le périmètre du problème
Avant tout profilage détaillé, il fallait vérifier si le ralentissement venait de la récupération des données, de leur mise en forme, ou de la conversion PDF elle-même. Un chronométrage grossier posé à trois points du processus a permis une première répartition : deux secondes pour la récupération des données, trois secondes pour la mise en forme HTML, et vingt et une secondes pour la conversion PDF proprement dite.
Le profilage détaillé de la conversion PDF
Un profileur PHP a été activé temporairement sur un environnement de test isolé, pour observer précisément où se concentrait ce temps de vingt et une secondes à l’intérieur de la bibliothèque de génération PDF utilisée. Le résultat a montré que 84 % du temps total se concentrait dans une seule fonction, chargée de calculer la position de saut de page pour chaque tableau du document.
Cette fonction recalculait, pour chaque ligne de chaque tableau, la hauteur totale du contenu déjà rendu depuis le début du document, en reparcourant l’intégralité des éléments précédents à chaque nouvelle ligne ajoutée. Sur un document comportant plusieurs tableaux de dizaines de lignes chacun, ce comportement en complexité quadratique expliquait à lui seul l’essentiel du temps de génération observé.
Le correctif appliqué
La bibliothèque de génération PDF proposait une méthode alternative de calcul de position, moins précise au pixel près mais suffisante pour un document de ce type, évitant le recalcul complet à chaque ligne. Le changement de méthode, documenté dans le code source de la bibliothèque mais peu mis en avant dans sa documentation publique, a nécessité une modification d’une dizaine de lignes dans la configuration du générateur PDF.
<?php
$pdf->setAutoPageBreak( true, 15 );
$pdf->SetY( -1 ); // désactive le recalcul de position par accumulation
$pdf->setPageBreakMode( 'basic' );
Ce changement de mode de calcul de saut de page a permis de conserver un rendu visuel quasiment identique, avec une tolérance de quelques millimètres sur certains sauts de page jugée acceptable après validation par l’équipe métier.
Résultat après correctif
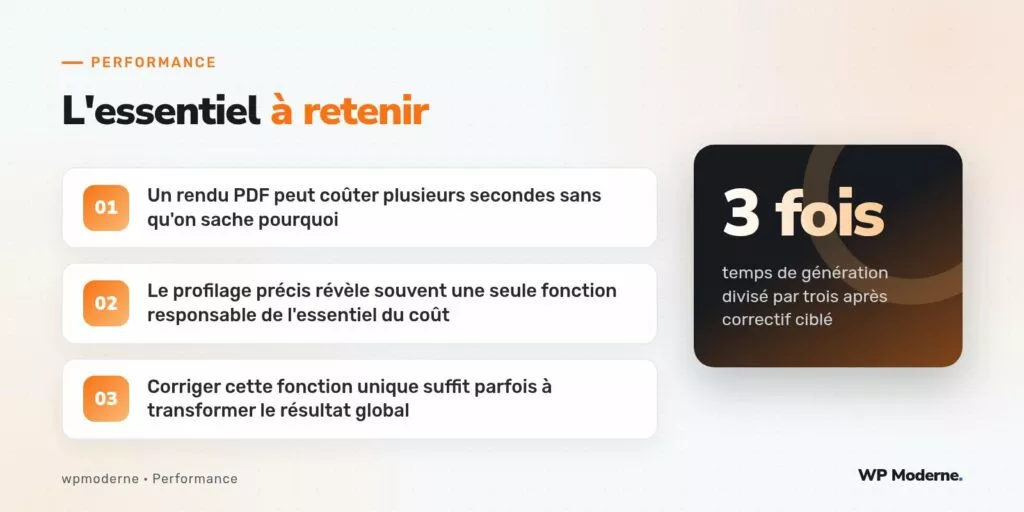
Le temps de génération du même document est tombé de vingt-six à huit secondes et demie, soit un facteur proche de trois. La part liée à la conversion PDF elle-même est passée de vingt et une à quatre secondes, confirmant que le correctif ciblait bien la source réelle du ralentissement plutôt qu’un symptôme périphérique.
- Récupération des données : deux secondes, inchangée
- Mise en forme HTML : trois secondes, inchangée
- Conversion PDF : passée de vingt et une à quatre secondes
Un audit de performance qui commence par un chronométrage grossier avant tout profilage fin évite de perdre du temps à optimiser la mauvaise partie du processus. Ici, corriger la mise en forme HTML n’aurait rien changé au problème réel.
Ce qu’il faut retenir de ce cas
Un temps de génération anormalement long ne provient presque jamais d’un ensemble diffus de petites lenteurs, mais souvent d’une seule fonction dont le comportement se dégrade fortement avec le volume de données traité. Le profilage précis, plutôt que l’intuition, reste le seul moyen fiable d’identifier ce type de goulet d’étranglement avant d’entreprendre une réécriture inutilement large du code concerné.