Le contrat de prestation était clair sur un point : aucune ligne de code source ne devait transiter par un service tiers non explicitement validé, y compris pour de simples vérifications automatisées. Cette clause, courante dans certains secteurs sensibles, exclut d’office l’usage des exécuteurs gérés proposés par défaut avec GitHub Actions, puisque ces machines appartiennent à une infrastructure hors du périmètre contractuel validé.
Ce qui suit décrit comment les vérifications automatisées de code, tests unitaires et analyse statique, ont été déplacées vers une machine hébergée en interne, sans aborder la configuration générale de GitHub Actions elle-même, déjà connue par ailleurs.
Le principe d’un exécuteur auto-hébergé
GitHub Actions permet de remplacer les exécuteurs gérés par une machine que l’on contrôle entièrement, appelée exécuteur auto-hébergé. Cette machine s’enregistre auprès du dépôt ou de l’organisation, reste à l’écoute de nouveaux travaux à exécuter, et les traite localement sans que le code ne quitte jamais l’infrastructure choisie. La syntaxe des fichiers de workflow ne change presque pas : seule la ligne désignant la machine cible est modifiée.
name: Vérifications
on: [push, pull_request]

jobs:
  tests:
    runs-on: self-hosted
    steps:
      - uses: actions/checkout@v4
      - name: Installer les dépendances
        run: composer install --no-interaction
      - name: Lancer les tests
        run: vendor/bin/phpunit
Le mot-clé self-hosted suffit à rediriger l’exécution vers la machine enregistrée, plutôt que vers l’infrastructure gérée par défaut.
Où héberger cet exécuteur
Le choix s’est porté sur une machine virtuelle dédiée, hébergée sur la même infrastructure que les environnements de préproduction du client, déjà couverte par le même contrat de confidentialité. L’exécuteur y tourne comme un service système, enregistré une fois via un jeton fourni par GitHub, et redémarre automatiquement en cas d’interruption. Aucune donnée ne remonte vers un service externe autre que GitHub lui-même pour la coordination des travaux, ce qui reste conforme à la clause contractuelle : celle-ci porte sur le contenu du code, pas sur les métadonnées d’orchestration.
Un point de vigilance a demandé une correction rapide après la mise en service : par défaut, un exécuteur auto-hébergé conserve le répertoire de travail entre deux exécutions successives. Un nettoyage explicite du répertoire a dû être ajouté en début de workflow pour éviter qu’un fichier de configuration temporaire d’une exécution précédente ne pollue la suivante.
Isoler l’exécuteur du reste de l’infrastructure
Un exécuteur auto-hébergé exécute du code arbitraire provenant des travaux qui lui sont soumis : c’est une porte d’entrée qui mérite d’être traitée avec la même vigilance qu’un serveur exposé. La machine a donc été placée sur un sous-réseau isolé, sans accès direct aux bases de données de production, avec des règles de pare-feu strictement limitées aux flux nécessaires vers les dépôts de paquets et vers l’API de GitHub.
- Aucun accès direct depuis l’exécuteur vers les serveurs de production
- Jetons d’accès à portée limitée, renouvelés régulièrement
- Journalisation systématique de chaque travail exécuté, pour audit ultérieur
Ce que cela a coûté en confort
Contrairement aux exécuteurs gérés, cette machine ne bénéficie d’aucune mise à l’échelle automatique : deux travaux simultanés se mettent en file d’attente au lieu de s’exécuter en parallèle sur des machines distinctes. Pour ce projet, dont le volume de travaux reste modéré, cette contrainte n’a pas posé de problème pratique. Elle deviendrait limitante sur un projet à fort volume de contributions simultanées, ce qui aurait alors justifié de provisionner plusieurs exécuteurs plutôt qu’un seul.
La maintenance de l’exécuteur, mises à jour système et surveillance de l’espace disque, incombe désormais à l’équipe elle-même, une responsabilité auparavant déléguée implicitement à l’infrastructure gérée.
Notre verdict
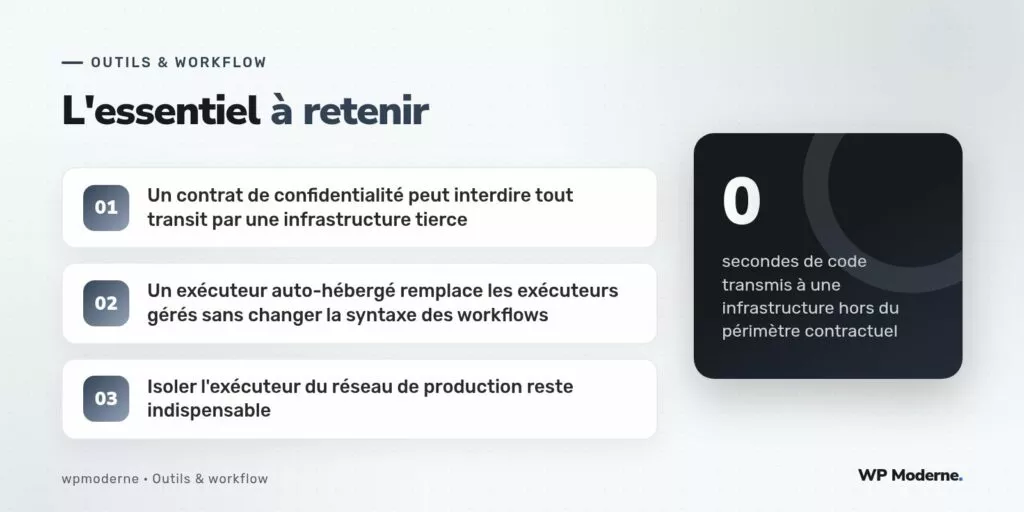
Pour un contrat qui impose explicitement que le code ne transite par aucune infrastructure tierce non validée, l’exécuteur auto-hébergé reste la seule option compatible, sans nécessiter de renoncer à l’intégration continue. Le surcoût en maintenance et en mise à l’échelle est réel, mais reste largement acceptable au regard de l’obligation contractuelle qu’il permet de satisfaire.