Symptôme : un client d’une agence partenaire a subi un piratage un vendredi soir. Les sauvegardes automatiques tournaient depuis des mois, stockées consciencieusement sur un espace S3 externe. Au moment de restaurer, l’archive SQL du jour précédent s’est révélée tronquée, coupée en plein milieu d’une table wp_posts. La sauvegarde existait, elle était même récente, mais elle ne servait à rien.
Ce genre d’incident ne relève pas de la malchance : une sauvegarde qui n’est jamais restaurée reste une hypothèse non vérifiée. Le correctif ne consiste pas à sauvegarder plus souvent, mais à automatiser un test de restauration périodique, dans un environnement jetable, qui valide que l’archive produite est réellement exploitable.
Diagnostic : pourquoi une sauvegarde peut être silencieusement cassée
Plusieurs causes reviennent régulièrement sur les parcs de sites suivis par l’agence :
- Un export
mysqldumpinterrompu par un timeout réseau, qui produit un fichier tronqué sans code de sortie en erreur si le script ne vérifie pas correctement le résultat. - Un espace disque insuffisant sur le serveur de sauvegarde, qui coupe l’archive en silence.
- Un dossier
wp-content/uploadspartiellement exclu par une règle de filtrage mal écrite, qui prive la restauration de médias essentiels. - Une clé de chiffrement de l’archive perdue ou changée entre deux versions du script de sauvegarde.
Dans tous ces cas, le job de sauvegarde se termine sans erreur visible. Rien ne signale le problème avant le jour où la restauration devient nécessaire, précisément le pire moment pour le découvrir.
Correctif : un job de restauration automatique et jetable
Le principe retenu par l’agence consiste à programmer, une fois par semaine, un job qui télécharge la dernière sauvegarde de chaque site, la restaure dans un conteneur MySQL et WordPress entièrement isolé, puis vérifie que le site répond correctement. Ce conteneur est détruit immédiatement après le test, qu’il réussisse ou échoue.
#!/usr/bin/env bash
set -euo pipefail

SITE=$1
BACKUP_DIR="/backups/${SITE}/latest"
CONTAINER="restore-test-${SITE}"

docker run -d --name "db-${CONTAINER}" \
  -e MARIADB_ROOT_PASSWORD=test \
  -e MARIADB_DATABASE=restore_test \
  mariadb:10.11

sleep 8

# Restauration de la base
gunzip -c "${BACKUP_DIR}/database.sql.gz" \
  | docker exec -i "db-${CONTAINER}" mysql -uroot -ptest restore_test

docker run -d --name "$CONTAINER" \
  --link "db-${CONTAINER}:db" \
  -e WORDPRESS_DB_HOST=db \
  -e WORDPRESS_DB_NAME=restore_test \
  -e WORDPRESS_DB_PASSWORD=test \
  -v "${BACKUP_DIR}/wp-content:/var/www/html/wp-content" \
  wordpress:6.4-php8.2

sleep 10

STATUS=$(docker exec "$CONTAINER" curl -s -o /dev/null -w "%{http_code}" http://localhost/)

if [ "$STATUS" != "200" ]; then
  echo "Échec de restauration pour ${SITE} : code HTTP ${STATUS}"
  exit 1
fi

docker exec "$CONTAINER" wp core is-installed --allow-root
docker exec "$CONTAINER" wp option get siteurl --allow-root

echo "Restauration validée pour ${SITE}"
docker rm -f "$CONTAINER" "db-${CONTAINER}"
Ce que ce script vérifie vraiment
Le contrôle ne s’arrête pas au code HTTP 200. La commande wp core is-installed confirme que WordPress reconnaît une installation valide, ce qui échoue si les tables essentielles sont absentes ou corrompues. La lecture de l’option siteurl confirme, elle, que la base restaurée contient bien des données cohérentes et pas une table vide créée par erreur lors de l’installation du conteneur.
Brancher une alerte dès l’échec
Un test qui échoue en silence, dans les logs d’un job cron perdu au milieu de la nuit, ne sert à rien de plus qu’une sauvegarde non testée. Le script est appelé depuis un job planifié qui capture son code de sortie et notifie l’équipe :
0 3 * * 1 /opt/scripts/test-restauration.sh client-boutique.example \
  || curl -s -X POST -H 'Content-Type: application/json' \
     -d '{"text":"Restauration de sauvegarde en échec pour client-boutique"}' \
     "$SLACK_WEBHOOK_URL"
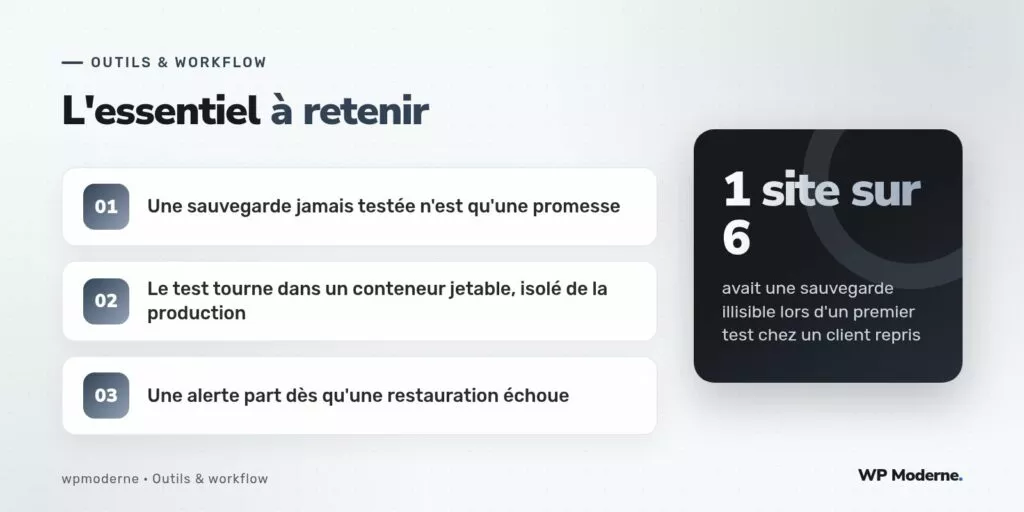
Sur le parc suivi par l’agence, ce test hebdomadaire a révélé, dans les trois premiers mois de mise en place, qu’un site sur six présentait une archive de sauvegarde illisible au moins une fois, pour des raisons variées : rotation de clé de chiffrement mal synchronisée, disque de sauvegarde plein, ou simplement un job de sauvegarde silencieusement arrêté après une mise à jour serveur.
Prévention : ce que ce test ne remplace pas
Ce contrôle valide qu’une archive est restaurable, pas qu’elle est récente ou complète du point de vue métier. Il reste nécessaire de vérifier séparément la fraîcheur de la sauvegarde, son antériorité par rapport à un incident potentiel, et la couverture des médias volumineux qui dépassent parfois les quotas de stockage du bac à sable de test. Ce mécanisme s’inscrit dans un plan de reprise plus large, qui couvre aussi la communication de crise et les procédures d’astreinte, hors du périmètre de cet article.
Une sauvegarde qui n’a jamais été restaurée n’est pas une sauvegarde, c’est un espoir stocké sur un disque.
En résumé
Automatiser la restauration périodique d’une sauvegarde dans un environnement jetable transforme une hypothèse en fait vérifié chaque semaine. Le coût de mise en place reste modeste, un script shell et un job cron, comparé au coût d’un incident découvert au pire moment. Sur les sites suivis par l’agence, ce test a évité au moins deux incidents où la restauration réelle aurait échoué exactement comme chez ce client piraté un vendredi soir.