Pourquoi un seuil de couverture de code bloquant finit-il presque toujours par être contourné plutôt que respecté ? Sur un projet où une pull request était rejetée automatiquement en dessous de soixante-dix pour cent de couverture, l’équipe a fini par écrire des tests qui exécutaient du code sans jamais vérifier son comportement, uniquement pour satisfaire le chiffre exigé par la vérification automatique.
Ce contournement n’est pas un signe de mauvaise volonté : c’est une réaction rationnelle face à une contrainte perçue comme un obstacle bureaucratique plutôt que comme une aide. Un seuil bloquant transforme la couverture de code en objectif à atteindre coûte que coûte, au lieu de rester un indicateur informatif sur la qualité réelle des tests écrits.
Le changement de posture : informer plutôt qu’imposer
La modification retenue a consisté à retirer entièrement le blocage automatique de la pull request en dessous d’un seuil, tout en conservant, voire en renforçant, la visibilité du chiffre de couverture pour chaque modification proposée. L’objectif est de garder l’information disponible sans la transformer en obstacle mécanique que l’on cherche à déjouer plutôt qu’à comprendre.
Mettre en place le commentaire automatique
La configuration repose sur l’exécution des tests avec génération d’un rapport de couverture, suivie d’un commentaire automatique déposé sur la pull request résumant l’évolution du chiffre par rapport à la branche principale :
- name: Exécuter les tests avec couverture
  run: vendor/bin/phpunit --coverage-clover=coverage.xml

- name: Commenter la pull request avec la couverture
  uses: irongut/CodeCoverageSummary@v1.3.0
  with:
    filename: coverage.xml
    format: markdown
    output: both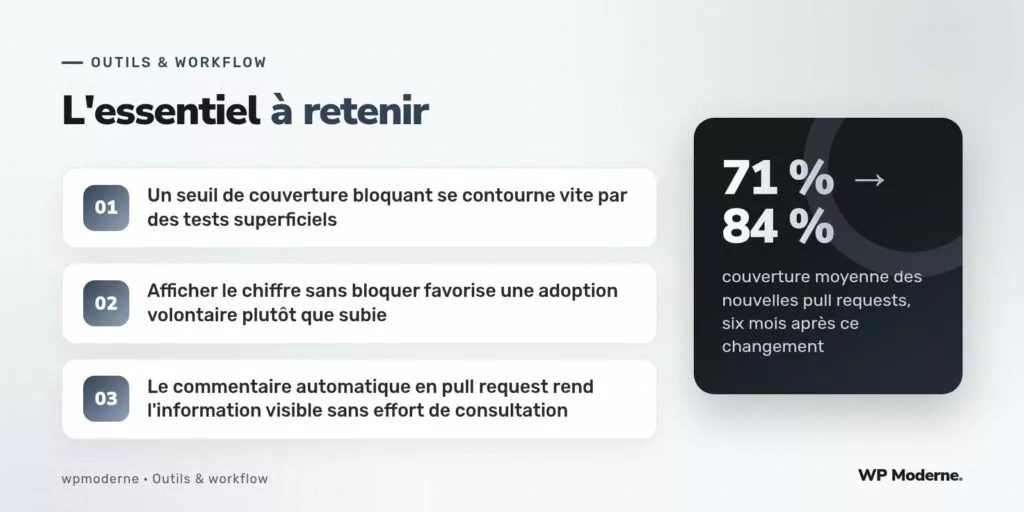
Le commentaire apparaît directement dans la conversation de la pull request, visible sans navigation supplémentaire vers un tableau de bord externe, ce qui abaisse considérablement la friction pour en tenir compte lors de la relecture du code.
Ce que ce changement a produit, mesuré sur six mois
La couverture moyenne des nouvelles pull requests est passée de soixante et onze pour cent, chiffre stagnant sous l’ancien régime bloquant, à quatre-vingt-quatre pour cent six mois après le retrait du blocage automatique. Ce résultat, à première vue contre-intuitif, s’explique par la disparition de l’incitation à écrire des tests superficiels uniquement pour franchir un seuil : sans cette pression artificielle, les tests écrits sont redevenus des vérifications de comportement réel, ce qui a naturellement amélioré la couverture au fil du temps plutôt que de la plafonner artificiellement autour du seuil imposé.
Le rôle de la relecture humaine dans ce dispositif
Retirer le blocage automatique ne signifie pas retirer toute exigence : la personne qui relit la pull request dispose désormais du chiffre de couverture comme élément de contexte parmi d’autres, au même titre que la lisibilité du code ou la pertinence de l’approche choisie. Une baisse significative de couverture sur une modification importante reste un motif légitime de discussion en relecture, mais cette discussion porte sur le fond — pourquoi cette baisse, est-elle justifiée — plutôt que sur un chiffre binaire imposé sans nuance.
- Le chiffre de couverture reste visible à chaque pull request, sans effort de consultation
- Aucun blocage automatique ne rejette une modification sur ce seul critère
- La relecture humaine reste responsable de juger si une variation de couverture est acceptable
Une exception assumée pour le code sensible
Ce principe général souffre une exception délibérée : le code touchant directement au paiement ou à la gestion des identifiants d’authentification conserve un seuil de couverture bloquant, documenté explicitement comme tel dans le fichier de configuration du projet, précisément parce que le risque associé à une régression non détectée y dépasse largement le bénéfice d’une plus grande liberté d’adoption.
Ce que cette approche ne remplace pas
Afficher un chiffre de couverture sans bloquer ne dit rien du choix de l’outil utilisé pour le mesurer, ni de la stratégie de test à adopter pour un projet donné — ces deux questions restent entières et méritent chacune leur propre réflexion, indépendante du mécanisme d’affichage retenu ici.
En résumé
Retirer un blocage automatique fondé sur un seuil de couverture de code, tout en conservant sa visibilité systématique en pull request, a paradoxalement amélioré la couverture réelle du projet plutôt que de la dégrader. Le mécanisme qui fonctionne n’est pas la contrainte mais l’information rendue disponible au bon moment, laissant à l’équipe la responsabilité d’en faire bon usage plutôt que de la subir comme un obstacle à contourner.