Sur un blog de conseils juridiques pour indépendants, chaque article traitait un sujet en profondeur mais sans jamais expliciter les questions concrètes que se posent réellement les lecteurs. Nous avons construit une recette qui transforme automatiquement un article existant en section FAQ structurée, en s’appuyant sur les informations déjà présentes dans le texte, sans jamais inventer de contenu nouveau.
Le point de départ était une contrainte stricte, imposée par le client lui-même : chaque question-réponse générée devait rester strictement fidèle à ce que l’article affirme, sans qu’aucune information supplémentaire ne s’ajoute au passage, une exigence particulièrement sensible sur un sujet juridique.
Le problème : extraire, pas inventer
La difficulté principale de cette tâche n’est pas de générer des questions plausibles, un LLM y parvient sans effort, mais de s’assurer que la réponse associée reste rigoureusement bornée par ce que le texte source affirme réellement. Un modèle mal guidé a tendance à compléter une réponse avec des informations générales sur le sujet, exactes en apparence, mais absentes de l’article et donc non vérifiées par le client.
Le prompt d’extraction contrainte
$prompt = "Voici un article de blog. Identifie entre 4 et 6 questions "
        . "concrètes qu'un lecteur pourrait se poser, dont la réponse "
        . "est EXPLICITEMENT présente dans le texte ci-dessous. "
        . "N'ajoute AUCUNE information qui ne figure pas dans le texte. "
        . "Réponds au format JSON : "
        . '[{"question": "...", "reponse": "..."}]' . "\n\n"
        . "Article :\n" . $contenu_article;
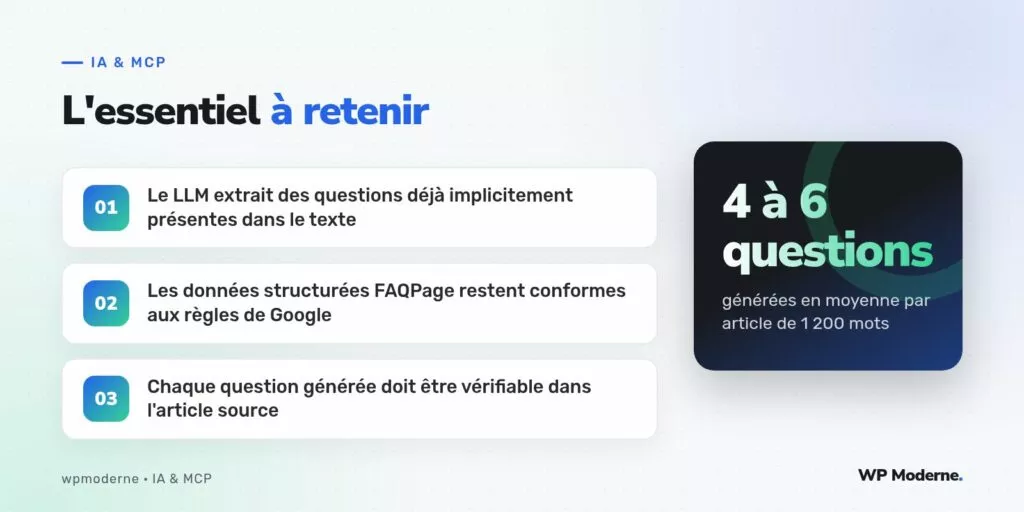
Sur un article de 1 200 mots environ, ce prompt produit en moyenne quatre à six paires question-réponse exploitables, une fois filtrées les propositions les plus faibles.
Le filtre de vérification avant publication
Avant toute publication, chaque réponse générée est comparée manuellement, par un membre de l’équipe éditoriale du client (un professionnel du droit, dans ce cas précis), au passage exact de l’article dont elle est censée provenir. Cette étape reste indispensable sur un sujet à enjeu juridique, où une réponse imprécise pourrait induire un lecteur en erreur.
- La question doit correspondre à une préoccupation réelle et fréquente des lecteurs
- La réponse ne doit contenir aucune affirmation absente du texte source
- Le professionnel valide ou reformule chaque réponse avant intégration
L’intégration en données structurées
Une fois validées, les questions-réponses sont insérées en fin d’article sous forme de blocs <h3> suivis d’un paragraphe, et le plugin injecte en parallèle le balisage Schema.org de type FAQPage dans le <head> du document via le hook wp_head, conformément aux exigences documentées par Google pour ce type de contenu structuré.
add_action( 'wp_head', function () {
    if ( ! is_singular( 'post' ) || ! has_faq_generee( get_the_ID() ) ) {
        return;
    }
    echo '<script type="application/ld+json">'
        . wp_json_encode( construire_donnees_faq_schema( get_the_ID() ) )
        . '</script>';
} );
Ce que le client a observé après six mois
Sur les articles ayant reçu une section FAQ validée, le temps moyen passé sur la page a légèrement augmenté, et plusieurs de ces articles ont commencé à apparaître dans des extraits enrichis de résultats de recherche, bien que ce type de visibilité reste soumis à la seule décision du moteur de recherche et ne puisse jamais être garanti à l’avance.
Une FAQ générée par IA n’a de valeur que si chaque réponse reste traçable jusqu’à la phrase exacte de l’article qui la justifie.
En résumé
Extraire des questions-réponses fidèles à un article existant demande un prompt volontairement restrictif et une vérification humaine systématique, particulièrement sur des sujets sensibles comme le droit. Bien exécutée, cette recette valorise un contenu déjà rédigé sans risque d’ajouter des informations non maîtrisées par l’auteur original.