Un an de journaux d’usage, additionnés poste par poste, donne rarement le chiffre qu’on imagine au départ. C’est le constat fait en reprenant, un an après sa mise en service, les coûts complets d’un agent qui croise les erreurs remontées par Sentry avec les tickets ouverts dans HubSpot, pour aider une équipe de support technique à prioriser les demandes liées à des bugs déjà identifiés côté développement.
L’agent tourne en continu depuis mai 2025 : à chaque nouveau ticket HubSpot marqué comme technique, il interroge Sentry via un serveur MCP pour savoir si une erreur correspondante existe déjà, et si oui, avec quelle fréquence et depuis quand. Le ticket est alors enrichi automatiquement d’un lien vers l’erreur Sentry et d’une estimation de priorité, sans jamais être fermé ou répondu automatiquement.
Décomposer la facture, pas seulement regarder le total
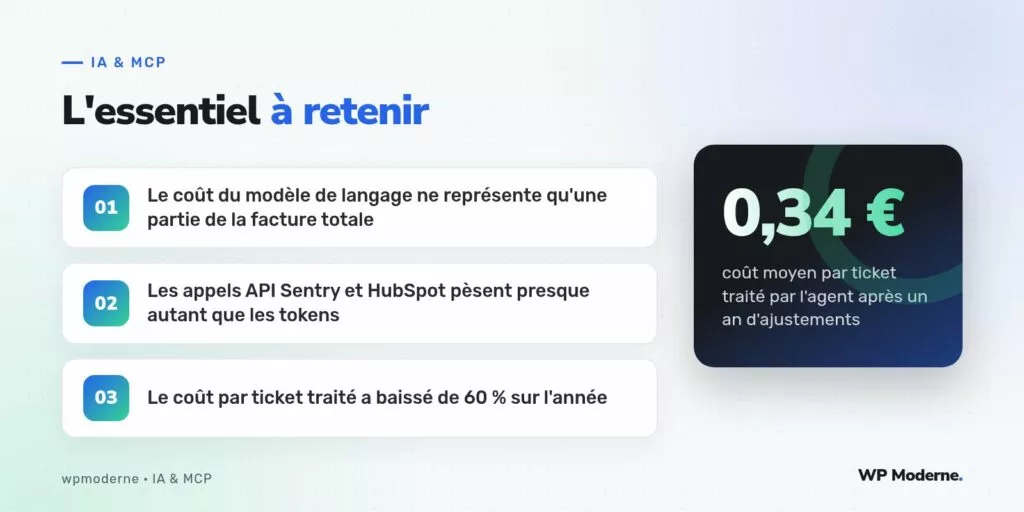
Le réflexe naturel consiste à ne suivre que le coût des tokens consommés par le modèle de langage, souvent le seul poste facilement visible dans un tableau de bord de fournisseur d’IA. Sur ce projet, ce poste ne représente en réalité qu’un peu plus de la moitié du coût total mensuel, le reste se répartissant entre les appels API Sentry (facturés au volume au-delà d’un certain quota) et les appels API HubSpot, eux aussi soumis à des limites qui peuvent entraîner des coûts de palier supérieur en cas de dépassement.
Évolution du coût par ticket sur l’année
| Période | Coût moyen par ticket traité | Poste principal |
|---|---|---|
| Mai à juillet 2025 | 0,89 € | Appels Sentry redondants sur les mêmes erreurs |
| Août à octobre 2025 | 0,52 € | Tokens du modèle, prompts encore trop longs |
| Novembre 2025 à janvier 2026 | 0,41 € | Cache introduit sur les erreurs Sentry déjà consultées |
| Février à avril 2026 | 0,34 € | Prompt raccourci, modèle plus économique sur les cas simples |
Les optimisations qui ont réellement payé
La première baisse notable est venue d’un cache local des erreurs Sentry déjà consultées dans les dernières vingt-quatre heures : de nombreux tickets concernent la même erreur récurrente, et interroger Sentry à chaque fois pour la même information était un gaspillage évident, corrigé par une simple table de cache dans la base WordPress hébergeant le connecteur.
- Mise en cache des réponses Sentry pendant 24 heures : environ 22 % de baisse du coût moyen
- Raccourcissement du prompt système, moins verbeux, sans perte de qualité mesurée sur les priorisations
- Routage vers un modèle moins coûteux pour les cas simples, réservant le modèle le plus performant aux tickets ambigus
Ce que ce chiffre ne dit pas
Le coût par ticket, aussi précis soit-il, ne capture pas le temps gagné par les techniciens support, qui n’ont plus à chercher manuellement si une erreur Sentry correspond à un ticket donné. Ce gain de temps, estimé à environ six minutes par ticket technique sur la base d’un échantillon observé, dépasse largement en valeur le coût de l’agent lui-même, même si les deux ne se comparent pas directement de la même manière.
Un coût par tâche qui ne baisse jamais après plusieurs mois d’usage est le signe qu’on n’a jamais vraiment cherché à l’optimiser.
En résumé
Le coût réel d’un agent connecté à plusieurs API ne se limite jamais aux tokens consommés par le modèle : les appels aux services tiers, ici Sentry et HubSpot, pèsent souvent autant sinon plus dans la facture totale. Sur ce projet, une année d’ajustements progressifs a permis de diviser le coût moyen par ticket par plus de deux, principalement grâce à la mise en cache des données déjà consultées plutôt qu’à un changement radical d’architecture.