Un rate limit de soixante requêtes par minute chez un fournisseur ne se traduit pas de la même façon qu’un rate limit de soixante requêtes par minute chez un autre, dès lors que l’un compte aussi les tokens consommés dans la limite et que l’autre ne compte que le nombre brut d’appels. Cette nuance, souvent ignorée en phase de conception, détermine pourtant directement la taille de la file d’attente à prévoir côté WordPress.
Le cas étudié ici concerne un traitement par lot : plusieurs centaines de fiches produit à enrichir automatiquement par un LLM, exécutées via Action Scheduler pour étaler la charge dans le temps plutôt que de saturer l’API en un seul passage.
Ce que recouvre réellement un rate limit
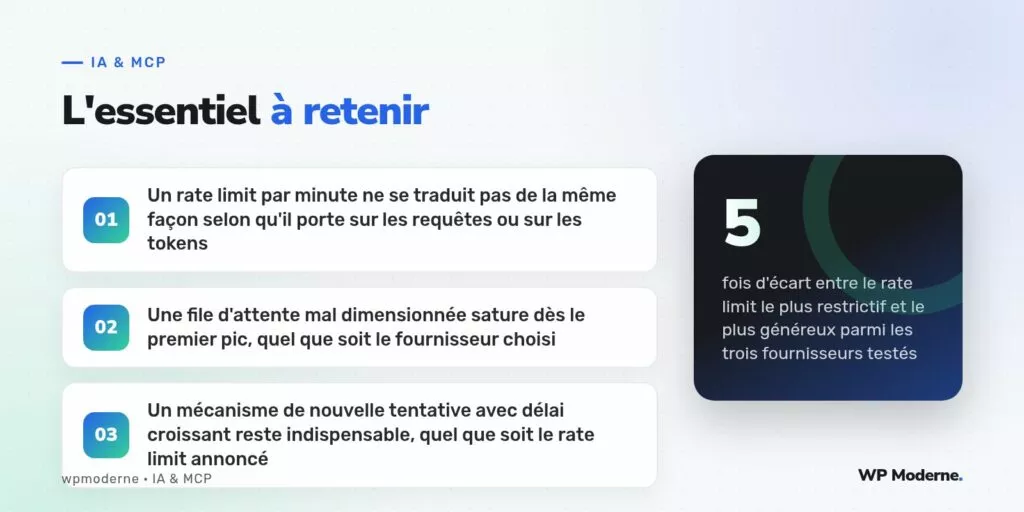
Trois fournisseurs comparés ici présentent des politiques de limitation sensiblement différentes. Le premier limite uniquement le nombre de requêtes par minute, sans tenir compte de leur taille. Le second combine une limite de requêtes et une limite de tokens consommés sur la même fenêtre de temps, ce qui pénalise davantage les appels contenant un texte long en entrée. Le troisième applique une limite par organisation plutôt que par clé d’API, ce qui devient un facteur bloquant si plusieurs projets partagent le même compte.
Cette dernière distinction s’est révélée la plus surprenante lors du test : deux projets de la même agence, utilisant la même clé d’API chez ce troisième fournisseur, se sont mutuellement ralentis sans qu’aucun des deux ne dépasse individuellement un volume élevé.
Dimensionner la file d’attente en conséquence
| Fournisseur | Type de limite | Appels/minute observés |
|---|---|---|
| Fournisseur A | Requêtes uniquement | Le plus généreux, x5 par rapport au plus restrictif |
| Fournisseur B | Requêtes et tokens combinés | Variable selon la taille des textes |
| Fournisseur C | Par organisation, partagée entre projets | Le plus restrictif en usage partagé |
Sur Action Scheduler, ce constat se traduit directement dans le paramétrage de l’intervalle entre chaque traitement de lot. Un intervalle fixe, calculé pour le fournisseur le plus généreux, sature immédiatement l’API du fournisseur le plus restrictif si le code est réutilisé sans ajustement.
Exemple de planification adaptative
function planifier_lot_enrichissement( $fiches_restantes ) {
    $intervalle = get_option( 'llm_rate_limit_intervalle', 5 );

    if ( ! empty( $fiches_restantes ) ) {
        $fiche = array_shift( $fiches_restantes );
        as_schedule_single_action(
            time() + $intervalle,
            'enrichir_fiche_produit',
            array( 'fiche_id' => $fiche, 'restantes' => $fiches_restantes )
        );
    }
}
L’intervalle stocké en option plutôt qu’en constante permet d’ajuster le rythme sans redéploiement, un point utile si le fournisseur modifie sa politique de limitation en cours de route, ce qui arrive plus souvent qu’on ne le pense.
La nouvelle tentative avec délai croissant
Quel que soit le fournisseur choisi, un dépassement occasionnel du rate limit reste possible, en particulier lors d’un pic de trafic imprévu sur le site. Un mécanisme de nouvelle tentative avec délai croissant (« backoff exponentiel ») absorbe ces dépassements sans faire échouer le traitement : un premier échec entraîne une nouvelle tentative après quelques secondes, un second échec après un délai plus long, jusqu’à un nombre maximal de tentatives.
Sans ce mécanisme, un simple dépassement ponctuel du rate limit se traduit par un échec définitif de la tâche, ce qui oblige à un traitement manuel des fiches non enrichies — un coût opérationnel bien supérieur à celui d’un mécanisme de nouvelle tentative correctement implémenté.
Le rate limit affiché sur la page de tarification d’un fournisseur ne dit jamais tout : seul un test en conditions réelles, avec le volume et la taille de contenu réellement prévus, révèle la limite qui compte vraiment.
Notre verdict
Le rate limiting ne se compare pas sur un seul chiffre affiché : il dépend de ce qu’il mesure réellement (requêtes, tokens, organisation) et de la façon dont la file d’attente WordPress est dimensionnée en conséquence. La question du coût par token de chacun de ces fournisseurs reste un sujet distinct, non traité dans ce comparatif centré sur le débit d’appels soutenable.