Le chatbot de support initial d’un client, déjà décrit dans un article précédent, répondait correctement aux questions simples mais produisait parfois des réponses plausibles et pourtant fausses sur des questions plus nuancées, sans qu’aucun signal ne distingue les deux cas côté utilisateur. La demande du client était claire : ne pas tout miser sur la qualité intrinsèque du modèle, mais construire un mécanisme qui sache reconnaître quand il vaut mieux transférer à un humain plutôt que de répondre.
Cette recette détaille comment ce score de confiance a été construit, et pourquoi nous avons délibérément évité de nous reposer uniquement sur l’auto-évaluation du modèle, jugée trop peu fiable seule.
Pourquoi l’auto-évaluation seule ne suffit pas
Demander simplement au modèle « es-tu sûr de ta réponse, donne une note sur 10 » produit une note, mais celle-ci reste elle-même une génération du modèle, sujette aux mêmes limites que la réponse qu’elle évalue. Un modèle peut se déclarer confiant sur une réponse fausse aussi facilement que sur une réponse correcte. Le score retenu dans cette recette combine donc l’auto-évaluation avec des critères vérifiables indépendamment du jugement du modèle lui-même.
Les critères qui composent le score
- Correspondance documentaire : la réponse s’appuie-t-elle sur un ou plusieurs extraits retrouvés dans la base de contenu du site, ou a-t-elle été générée sans source identifiable ?
- Auto-évaluation du modèle : une note demandée explicitement, pondérée mais jamais utilisée seule.
- Ambiguïté détectée dans la question : la question contient-elle des termes vagues ou plusieurs interprétations possibles, détectées par une analyse simple du texte reçu ?
- Historique de la catégorie de question : ce type de question a-t-il, dans le passé, généré un taux élevé de corrections humaines après coup ?
Le calcul du score
function agence_calculer_score_confiance( $reponse, $sources, $question ) {
    $score = 0.0;

    // Présence de sources documentaires (poids le plus important)
    $score += empty( $sources ) ? 0 : 0.4;

    // Auto-évaluation du modèle, ramenée sur 0.3 max
    $score += min( $reponse['auto_evaluation'] / 10, 1 ) * 0.3;

    // Pénalité si la question contient des marqueurs d'ambiguïté
    $marqueurs_ambigus = array( 'peut-être', 'dans certains cas', 'ça dépend' );
    foreach ( $marqueurs_ambigus as $marqueur ) {
        if ( stripos( $question, $marqueur ) !== false ) {
            $score -= 0.1;
        }
    }

    // Bonus si la catégorie a un historique de faible correction
    $taux_correction = agence_taux_correction_categorie( $question );
    $score += ( 1 - $taux_correction ) * 0.3;

    return max( 0, min( 1, $score ) );
}
Le seuil de transfert vers un humain
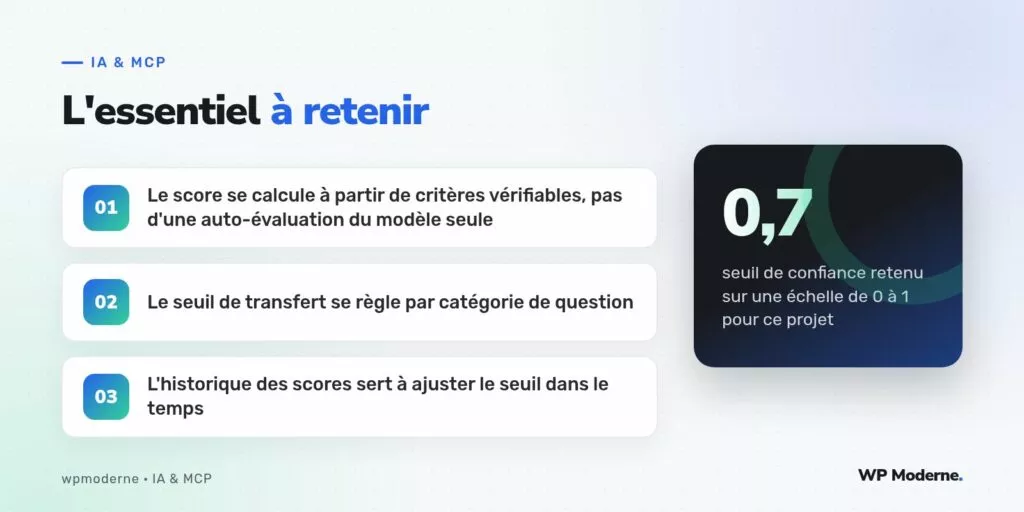
Après plusieurs semaines de calibrage, le seuil retenu pour ce projet est de 0,7 sur une échelle de 0 à 1 : en dessous, la réponse générée est tout de même conservée en interne, mais présentée à l’utilisateur comme un transfert vers un conseiller, avec un délai de prise en charge annoncé plutôt qu’une réponse incertaine.
| Score obtenu | Traitement |
|---|---|
| 0,7 et plus | Réponse envoyée directement à l’utilisateur |
| Entre 0,4 et 0,7 | Transfert à un humain, réponse générée jointe comme suggestion |
| Moins de 0,4 | Transfert prioritaire, réponse générée non affichée au conseiller |
Ajuster le seuil dans la durée
Chaque réponse envoyée directement, avec son score, est conservée avec un indicateur de correction ultérieure si un utilisateur signale un problème ou si un conseiller repère une erreur en aval. Cet historique sert de base mensuelle pour ajuster le seuil : un score de 0,7 associé à un taux de correction encore trop élevé sur une catégorie précise de questions justifie de relever le seuil spécifiquement pour cette catégorie.
Un score de confiance mal calibré donne une fausse impression de maîtrise. Il ne vaut que ce que vaut la vérification régulière de sa corrélation avec les erreurs réellement constatées.
En résumé
Un score de confiance fiable combine des critères vérifiables indépendamment du modèle — présence de sources, historique de la catégorie de question — avec son auto-évaluation, jamais utilisée seule. Le seuil de transfert vers un humain n’est pas une constante universelle : il se calibre par catégorie de question et s’ajuste dans la durée, à partir des corrections réellement constatées après coup, pas seulement au moment de la mise en production initiale.