Un site entièrement headless n’affiche plus aucune page WordPress au visiteur final : ni articles, ni pages, ni sitemap. Le sitemap XML natif, généré automatiquement par WordPress depuis la version 5.5, reste accessible techniquement à l’URL /wp-sitemap.xml, mais il pointe vers des URLs WordPress que le visiteur ne verra jamais, puisque le front réel vit sur un autre domaine avec sa propre structure de routes.
Cette recette explique comment reconstruire un sitemap pertinent côté Next.js, à partir des données de l’API REST, sans entrer dans le sujet plus large du SEO headless déjà traité ailleurs sur ce blog.
Le problème posé par le sitemap natif
Le sitemap généré par WordPress liste des URLs de la forme https://api.exemple.fr/mon-article/, alors que l’URL réelle vue par les visiteurs est https://exemple.fr/blog/mon-article. Soumettre le sitemap natif à la Search Console reviendrait à indiquer à Google des pages qui n’existent pas publiquement, ce qui nuit directement au référencement plutôt que de l’aider.
La recette : une route API Next.js régénérée à chaque build
La solution retenue s’appuie sur une route API Next.js qui interroge l’API REST de WordPress pour récupérer tous les contenus publiés, puis construit le fichier XML attendu par les moteurs de recherche :
// pages/sitemap.xml.js
const BASE_URL = 'https://exemple.fr'
const WP_API = 'https://api.exemple.fr/wp-json/wp/v2'

async function recupererTout(type) {
  let page = 1
  let resultats = []
  let continuer = true

  while (continuer) {
    const reponse = await fetch(
      `${WP_API}/${type}?per_page=100&page=${page}&_fields=slug,modified_gmt`
    )
    const donnees = await reponse.json()
    resultats = resultats.concat(donnees)
    continuer = donnees.length === 100
    page += 1
  }
  return resultats
}

function construireXml(urls) {
  const items = urls
    .map(
      (u) => `
    <url>
      <loc>${BASE_URL}${u.chemin}</loc>
      <lastmod>${u.modified_gmt}</lastmod>
    </url>`
    )
    .join('')

  return `<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">${items}
</urlset>`
}

export async function getServerSideProps({ res }) {
  const [articles, pages, formations] = await Promise.all([
    recupererTout('posts'),
    recupererTout('pages'),
    recupererTout('formation'),
  ])

  const urls = [
    ...articles.map((a) => ({ chemin: `/blog/${a.slug}`, modified_gmt: a.modified_gmt })),
    ...pages.map((p) => ({ chemin: `/${p.slug}`, modified_gmt: p.modified_gmt })),
    ...formations.map((f) => ({ chemin: `/formations/${f.slug}`, modified_gmt: f.modified_gmt })),
  ]

  res.setHeader('Content-Type', 'text/xml')
  res.write(construireXml(urls))
  res.end()

  return { props: {} }
}

export default function Sitemap() {
  return null
}
Pourquoi getServerSideProps plutôt qu’un fichier statique
Sur ce projet, le choix s’est porté sur une génération à la demande via getServerSideProps plutôt qu’un export statique figé au build, pour que le sitemap reste à jour même entre deux déploiements complets du front, tant que le contenu WordPress change plus souvent que le code lui-même. Le compromis, c’est un léger temps de réponse à chaque appel du robot d’indexation, largement acceptable pour un fichier consulté occasionnellement plutôt qu’à chaque visite.
Séparer les sitemaps par type de contenu
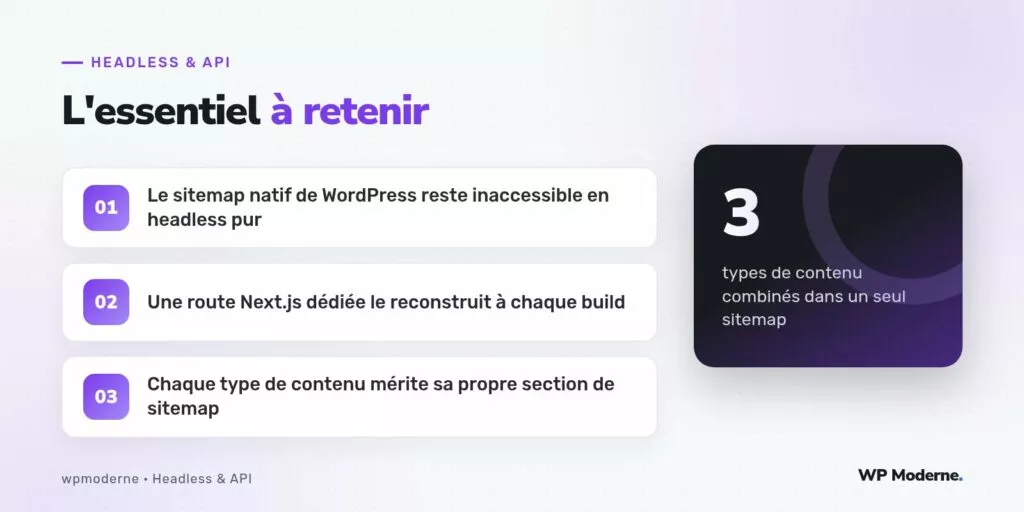
Passé quelques milliers d’URLs, un sitemap unique devient difficile à maintenir et dépasse parfois la limite de cinquante mille URLs par fichier imposée par le protocole. La bonne pratique consiste à découper en plusieurs fichiers, un par type de contenu, reliés par un fichier d’index :
/sitemap-articles.xmlpour les articles de blog./sitemap-pages.xmlpour les pages statiques./sitemap-formations.xmlpour le type de contenu personnalisé./sitemap.xmlcomme index listant les trois fichiers précédents.
Désactiver le sitemap natif pour éviter la confusion
Pour ne pas laisser deux sitemaps concurrents accessibles, le sitemap natif de WordPress est désactivé côté API avec le filtre prévu à cet effet :
add_filter( 'wp_sitemaps_enabled', '__return_false' );
Un sitemap qui pointe vers des URLs inexistantes n’est jamais neutre pour Google : mieux vaut aucun sitemap qu’un sitemap trompeur.
En résumé
Passer en headless complet retire au passage un service que WordPress rendait gratuitement depuis sa version 5.5. Le reconstruire côté front demande une route dédiée, un découpage par type de contenu au-delà d’un certain volume, et la désactivation explicite du sitemap natif pour éviter toute confusion. Une fois en place, ce dispositif tourne sans intervention manuelle, et la Search Console continue de recevoir des URLs qui correspondent réellement à ce que voient les visiteurs.