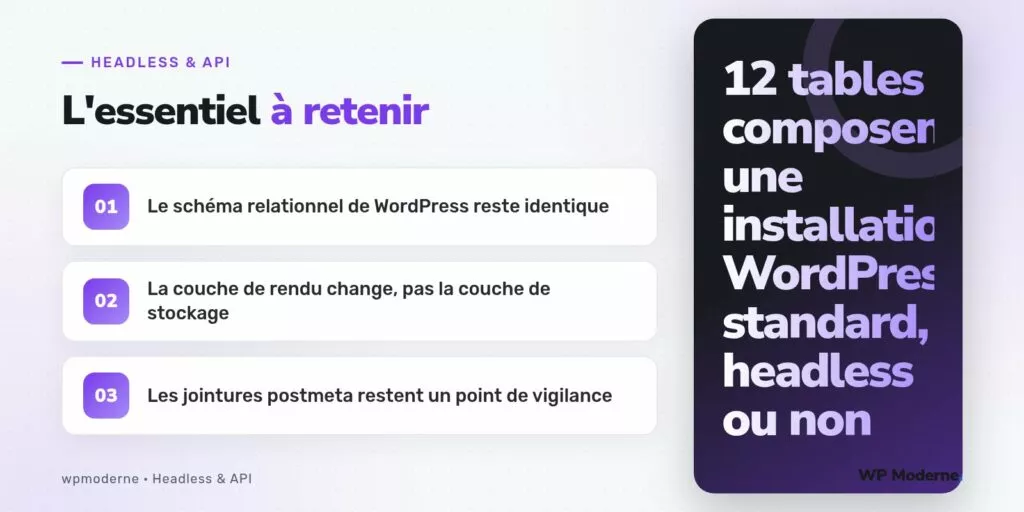
Basculer un projet WordPress vers une architecture headless donne parfois l’impression, à tort, que la base de données elle-même s’en trouve transformée. En réalité, le schéma relationnel ne bouge pas d’un pouce : les mêmes douze tables d’une installation WordPress standard — wp_posts, wp_postmeta, wp_terms, wp_term_relationships, wp_users, et les autres — continuent de structurer le contenu exactement comme sur un site rendu classiquement par un thème PHP.
Ce constat, souvent négligé au moment de planifier un projet découplé, mérite d’être posé clairement : ce qui change en headless, c’est la couche de rendu, jamais la couche de stockage. Comprendre ce qui reste stable permet d’éviter des choix d’architecture inutiles, comme migrer prématurément vers des tables personnalisées pour un gain de performance qui n’existe pas réellement à ce niveau.
L’arborescence relationnelle, inchangée
Voici la structure simplifiée qui reste identique, que le rendu soit confié à un thème classique ou à un front totalement découplé :
wp_posts (id, post_title, post_content, post_status, post_type…)
 ├── wp_postmeta (post_id, meta_key, meta_value)
 │    └── un couple clé/valeur par ligne, non typé
 ├── wp_term_relationships (object_id, term_taxonomy_id)
 │    └── wp_term_taxonomy (term_taxonomy_id, term_id, taxonomy)
 │         └── wp_terms (term_id, name, slug)
 └── wp_comments (comment_post_ID, comment_content, comment_approved)

wp_users (ID, user_login, user_pass…)
 └── wp_usermeta (user_id, meta_key, meta_value)
Aucune de ces tables ne connaît l’existence d’une API REST, d’un schéma GraphQL ou d’un front React. Elles stockent du contenu relationnel, point final. C’est la couche applicative au-dessus — WP_REST_Server, ou l’extension WPGraphQL — qui traduit ce schéma en réponses structurées consommables par un front.
Ce qui pose problème : la structure clé-valeur de wp_postmeta
La table wp_postmeta stocke chaque métadonnée sur une ligne distincte, sous forme de paire clé-valeur non typée. Cette conception, pensée pour une flexibilité maximale côté PHP, devient une contrainte pour une API REST qui doit exposer ces métadonnées sous forme de champs typés et nommés dans un objet JSON. Chaque champ personnalisé exposé via register_rest_field() ou ACF nécessite donc une jointure ou une requête supplémentaire vers cette table, ce qui explique en partie pourquoi une réponse REST enrichie de nombreux champs personnalisés peut multiplier les requêtes SQL sous-jacentes.
Pourquoi migrer vers des tables personnalisées reste rarement justifié
Face à ce constat, certaines équipes envisagent de créer des tables SQL personnalisées, en dehors du schéma WordPress standard, pour gagner en performance de lecture. Cette voie existe (via dbDelta() et l’API $wpdb), mais elle a un coût élevé : elle sort le contenu du système de capacités WordPress, de la corbeille, des révisions, et de la compatibilité avec l’écosystème d’extensions qui suppose que le contenu réside dans wp_posts. Pour la grande majorité des projets headless, ce coût dépasse largement le gain de performance espéré, surtout quand une simple mise en cache des réponses REST atteint le même objectif à moindre effort.
- Une table personnalisée perd l’historique des révisions géré nativement par WordPress.
- Elle perd aussi l’intégration avec les capacités et rôles utilisateurs sans réimplémentation manuelle.
- Le gain de performance qu’elle promet est souvent obtenu plus simplement par un cache HTTP en amont de l’API.
Ce qui change réellement en headless
La bascule headless déplace la complexité du rendu HTML vers la traduction du schéma relationnel en réponses structurées. Le schéma de base reste un détail d’implémentation interne à WordPress, que le front n’a jamais besoin de connaître directement : il consomme des routes REST ou des types GraphQL, jamais des tables SQL. C’est précisément cette séparation qui permet de changer complètement de front (passer de Next.js à Astro, par exemple) sans toucher à une seule ligne du schéma de base sous-jacent.
En résumé
Un projet headless ne change rien à la façon dont WordPress stocke le contenu en base de données : le schéma relationnel de wp_posts et de ses tables associées reste le même socle qu’un site rendu classiquement. La vraie transformation se joue entièrement dans la couche qui traduit ce schéma en réponses consommables par un front découplé, et c’est là, plutôt que dans le schéma lui-même, qu’il faut concentrer les efforts d’optimisation.