Trois connecteurs HubSpot, trois clients différents, développés par trois prestataires distincts sur une période de deux ans : les mêmes trois défauts structurels sont ressortis, presque à l’identique, lors d’un audit technique mené pour une agence qui reprenait leur maintenance. Ce constat, plus qu’anecdotique, dessine un schéma récurrent dans la façon dont les connecteurs CRM sont bâtis sous la pression d’un planning serré. Ce billet reste centré sur HubSpot ; Salesforce, avec son propre modèle d’objets et ses propres pièges, mérite un traitement séparé.
Ce qu’on observe : la synchronisation à sens unique
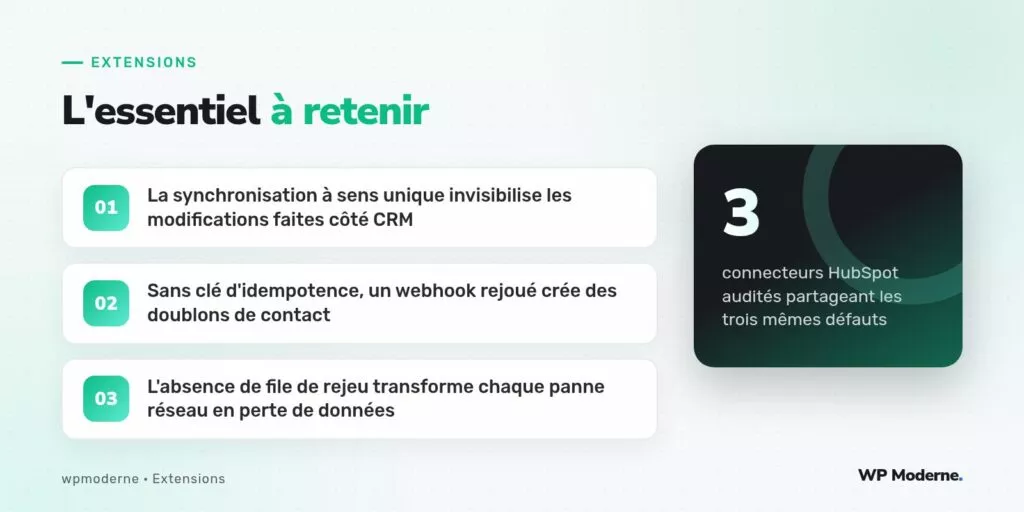
Les trois connecteurs envoyaient les nouveaux contacts WordPress vers HubSpot à la création d’un formulaire, mais aucun ne rapatriait les modifications faites côté CRM (changement de statut commercial, fusion de doublons, mise à jour d’un champ personnalisé par l’équipe commerciale). Résultat : au bout de quelques mois, les deux systèmes divergeaient silencieusement, chacun devenant une source de vérité partielle et contradictoire.
Pourquoi c’est un problème concret
Sur l’un des trois clients, un contact marqué comme « désabonné » dans HubSpot après une demande de retrait continuait de recevoir des notifications automatiques déclenchées côté WordPress, car l’extension ignorait totalement cet état. La situation exposait le client à un risque de non-conformité RGPD, bien au-delà d’un simple inconfort technique.
Ce qu’on observe : des doublons de contacts
Le deuxième défaut partagé : l’absence de vérification d’idempotence avant création d’un contact dans HubSpot. Un formulaire soumis deux fois (double clic, rechargement de page après un timeout) créait systématiquement deux fiches distinctes, sans qu’aucune des trois extensions ne recherche d’abord un contact existant par adresse e-mail.
// Ce qui était fait : création aveugle
$response = wp_remote_post( 'https://api.hubapi.com/crm/v3/objects/contacts', array(
    'headers' => array( 'Authorization' => 'Bearer ' . $token ),
    'body'    => wp_json_encode( array( 'properties' => $properties ) ),
) );

// Ce qui aurait dû être fait : recherche puis upsert
$existing = wpm_hubspot_find_contact_by_email( $properties['email'] );

if ( $existing ) {
    wpm_hubspot_update_contact( $existing['id'], $properties );
} else {
    wpm_hubspot_create_contact( $properties );
}
HubSpot propose d’ailleurs un point d’entrée d’upsert natif (/crm/v3/objects/contacts avec l’en-tête idProperty réglé sur email), qui évite précisément ce genre de recherche manuelle — aucun des trois connecteurs audités ne l’utilisait, chacun ayant réinventé une logique de création simple, plus rapide à écrire en urgence.
Ce qu’on observe : l’absence de rejeu
Le troisième défaut, le plus coûteux en pratique : quand l’API HubSpot renvoyait une erreur temporaire (limite de débit atteinte, panne de quelques minutes), les trois extensions se contentaient de journaliser l’échec, sans file d’attente permettant de rejouer l’envoi plus tard. Chaque incident réseau, même bref, se traduisait par une perte de contact définitive.
Quoi faire à la place
- Mettre en place une synchronisation bidirectionnelle a minima sur les champs critiques (statut d’abonnement, consentement), via les webhooks HubSpot plutôt qu’un simple envoi sortant.
- Systématiser une recherche par identifiant unique (e-mail ou identifiant externe) avant toute création, en s’appuyant sur les points d’entrée d’upsert natifs de l’API.
- Stocker chaque tentative d’envoi dans une table de file d’attente locale, avec un statut (en attente, envoyé, échoué) et un nombre de tentatives, rejouée par Action Scheduler.
- Ajouter une alerte visible dans l’administration WordPress dès qu’un envoi échoue plus de trois fois consécutives, plutôt que de laisser l’échec invisible dans un fichier de log.
Un connecteur CRM qui ne gère pas le rejeu n’est pas un connecteur incomplet : c’est un connecteur qui perd des prospects sans le dire à personne.
En résumé
Ces trois défauts partagent une origine commune : ils sont invisibles en environnement de démonstration, où tout fonctionne du premier coup, et ne se révèlent qu’à l’usage, sous charge réelle, avec de vrais aléas réseau. Auditer un connecteur CRM impose donc de simuler délibérément la panne, le doublon et la modification côté CRM, plutôt que de se fier au seul test du chemin heureux.