Un client spécialisé dans la quincaillerie professionnelle avait importé plusieurs milliers de références depuis un fournisseur, chacune avec une fiche technique correcte mais sans la moindre description commerciale exploitable — seulement une nomenclature du fabricant, illisible pour un acheteur final. Réécrire trois mille descriptions à la main n’était pas envisageable dans le délai imparti. La solution retenue : un pipeline de génération par lots, avec un modèle de langage encadré par des règles précises et une revue humaine systématique par échantillon, plutôt qu’une génération en autonomie complète.
Cette recette ne couvre pas la génération d’images produit, un sujet distinct avec ses propres contraintes ; elle se limite au texte commercial.
Le problème : un prompt libre produit un texte inégal
Une première tentative, avec un prompt volontairement simple (« rédige une description commerciale pour ce produit »), a produit des résultats très inégaux d’une référence à l’autre : certaines descriptions inventaient des caractéristiques absentes de la fiche technique fournie, d’autres reprenaient presque mot pour mot la nomenclature du fabricant sans y ajouter de valeur commerciale. Le problème ne venait pas de la qualité du modèle, mais de l’absence de contrainte structurelle sur ce qu’il devait produire.
Le snippet : un prompt structuré et contraint
function construire_prompt_description( $produit ) {
    $attributs = array();
    foreach ( $produit->get_attributes() as $attribut ) {
        $attributs[] = $attribut->get_name() . ' : ' . implode( ', ', $attribut->get_options() );
    }

    return sprintf(
        "Rédige une description commerciale de 400 à 600 caractères pour ce produit.\n" .
        "Nom du produit : %s\n" .
        "Catégorie : %s\n" .
        "Attributs techniques (n'invente rien en dehors de cette liste) :\n%s\n" .
        "Contraintes : pas de superlatif non justifié, pas de prix, pas de promesse de livraison, " .
        "ton professionnel, phrases courtes, aucune caractéristique technique absente de la liste ci-dessus.",
        $produit->get_name(),
        implode( ', ', wp_get_post_terms( $produit->get_id(), 'product_cat', array( 'fields' => 'names' ) ) ),
        implode( "\n", $attributs )
    );
}
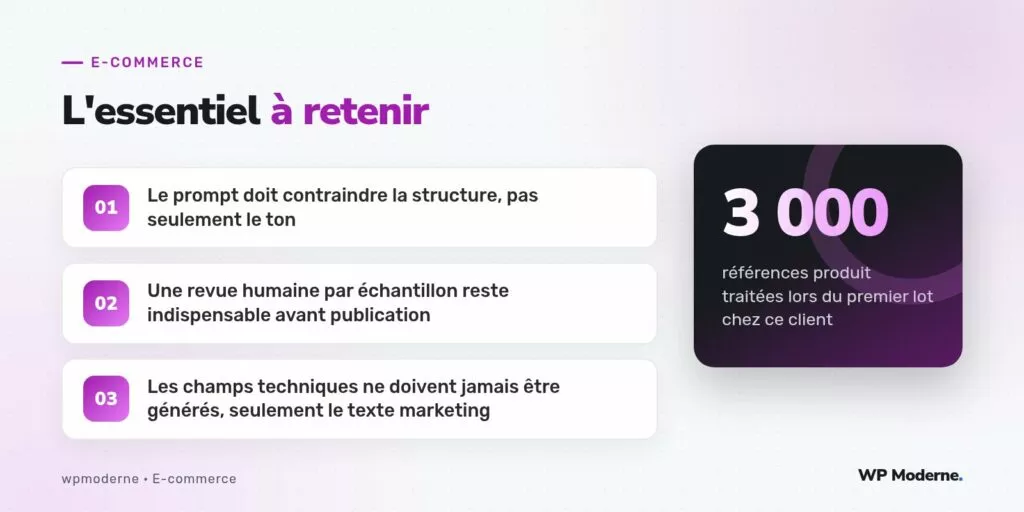
La contrainte la plus importante s’est révélée être la liste explicite des attributs techniques autorisés, avec l’instruction stricte de ne rien ajouter en dehors. Sans cette liste fermée, le modèle avait tendance à inventer des caractéristiques plausibles mais fausses — un matériau, une norme de résistance — pour combler ce qui lui semblait être un manque d’information dans la fiche produit.
Le traitement par lots, pas produit par produit en direct
Plutôt que de générer chaque description à la demande au moment de l’affichage, le choix a été fait de traiter les références par lots de cinquante, via une tâche planifiée s’appuyant sur Action Scheduler, avec écriture du résultat dans un champ personnalisé de brouillon (_description_generee_brouillon) distinct du champ de description publiée. Ce découplage a permis d’insérer une étape de revue humaine entre la génération et la publication, sans bloquer le reste du site pendant le traitement.
La revue humaine, non négociable
Sur les trois mille références traitées, une revue exhaustive n’était pas réalisable dans le délai du projet. La méthode retenue : une revue systématique d’un échantillon aléatoire de 10 % des descriptions générées, complétée par une revue ciblée de toutes les références appartenant à des catégories jugées sensibles (produits liés à la sécurité électrique, par exemple, où une erreur de description pourrait avoir des conséquences réelles). Le taux d’erreur constaté sur l’échantillon a permis de décider, catégorie par catégorie, si la publication automatique était envisageable ou si une revue exhaustive s’imposait.
Ce qui n’a jamais été généré
- Les champs techniques structurés (dimensions, poids, matière) : toujours issus directement de la fiche fournisseur, jamais reformulés ou complétés par le modèle.
- Le prix et les informations de stock : générés nulle part, affichés dynamiquement comme sur n’importe quelle fiche produit WooCommerce classique.
- Les mentions réglementaires obligatoires sur certaines catégories de produits : ajoutées séparément via un modèle de texte fixe, jamais laissées à l’appréciation du modèle de langage.
Un modèle de langage rédige bien quand on lui interdit d’inventer. La qualité du résultat final tient presque entièrement à la précision des contraintes du prompt, beaucoup plus qu’au choix du modèle lui-même.
Variantes possibles
Sur un catalogue avec moins de contraintes réglementaires, la même recette peut s’assouplir : autoriser un ton plus commercial, générer également une accroche courte pour les résultats de recherche, ou produire plusieurs variantes de longueur pour différents emplacements d’affichage. La discipline sur la liste fermée d’attributs techniques autorisés, en revanche, reste valable quel que soit le secteur, tant qu’on veut éviter qu’un modèle ne complète de lui-même une information technique absente.
En résumé
Générer des descriptions produit par lots avec un modèle de langage fonctionne bien à condition de traiter le modèle comme un rédacteur contraint, pas comme un expert autonome : une liste fermée de faits autorisés, un traitement asynchrone découplé de la publication, et une revue humaine par échantillon calibrée selon la sensibilité de chaque catégorie de produits.