« Le bloc a été migré automatiquement » entend-on parfois d’un client après un incident de contenu, alors qu’en réalité rien n’a été migré du tout, seulement invalidé. Cette confusion entre validation, migration et récupération revient souvent, y compris chez des développeurs expérimentés qui manipulent ces mécanismes sans toujours distinguer précisément où s’arrête la responsabilité de chacun.
La validation : un simple comparateur, jamais un correcteur
La validation de bloc consiste à recalculer le rendu attendu à partir des attributs actuels (via la fonction save active) et à le comparer au HTML réellement stocké dans post_content. Si les deux diffèrent au-delà d’une tolérance de normalisation d’espaces, le bloc est marqué invalide. C’est tout ce que fait la validation : elle constate un écart, elle ne modifie jamais le contenu stocké, et elle ne sait absolument rien de la cause de cet écart, qu’il s’agisse d’un vrai changement de structure ou d’une simple différence d’encodage de caractères.
La migration : transformer un ancien format vers le nouveau
La migration intervient dans le cadre du tableau deprecated de registerBlockType. Chaque entrée de ce tableau décrit un ancien schéma d’attributs et un ancien save, avec optionnellement une fonction migrate qui transforme les anciennes valeurs d’attributs vers le nouveau format actif. La migration ne s’exécute que lorsque l’éditeur détermine, via isEligible ou par correspondance de structure, qu’une entrée de déprécation correspond au contenu stocké.
const v1 = {
  attributes: { titre: { type: 'string', source: 'text', selector: 'h3' } },
  migrate({ titre }) {
    return { titre: titre.toUpperCase(), soulignement: false };
  },
  save({ attributes }) { /* ancien rendu */ },
};
Un point souvent mal compris : la migration ne s’exécute qu’au moment où l’éditeur charge et affiche ce bloc précis dans son interface. Un article jamais rouvert dans l’éditeur depuis la mise à jour du bloc conserve indéfiniment son ancien format d’attributs en base de données, migré uniquement « à la volée » en mémoire à chaque chargement, jusqu’à ce que l’article soit resauvegardé.
La récupération : une action manuelle, jamais automatique
La récupération (« Attempt Block Recovery » dans l’interface, aussi appelée « Tenter la récupération ») est le bouton proposé à l’utilisateur lorsque l’éditeur ne parvient à faire correspondre le contenu invalide à aucune entrée de déprécation connue. Contrairement à la migration, elle n’est jamais déclenchée automatiquement : c’est un choix explicite de l’utilisateur, qui accepte que l’éditeur retente de parser le contenu stocké avec la structure actuelle, au prix potentiel d’une perte de mise en forme si les deux structures divergent trop.
Où ces trois mécanismes s’articulent dans le temps
| Mécanisme | Déclenchement | Modifie le contenu stocké ? |
|---|---|---|
| Validation | Automatique, à chaque ouverture du bloc | Non, seulement un constat |
| Migration | Automatique, si une entrée deprecated correspond | En mémoire seulement, jusqu’à resauvegarde |
| Récupération | Manuelle, choix explicite de l’utilisateur | Oui, dès acceptation |
Pièges fréquents
- Croire qu’un bloc « invalidé » a perdu son contenu : le contenu original reste intact en base tant qu’aucune sauvegarde n’a eu lieu après une récupération acceptée.
- Écrire une fonction
migratesans jamais la tester sur un contenu réel invalidé, en supposant à tort qu’elle s’exécute systématiquement au chargement de n’importe quel article. - Confondre l’absence d’entrée
deprecatedcorrespondante avec un bug de migration : sans entrée correspondante, il n’y a simplement rien à migrer, seulement une proposition de récupération.
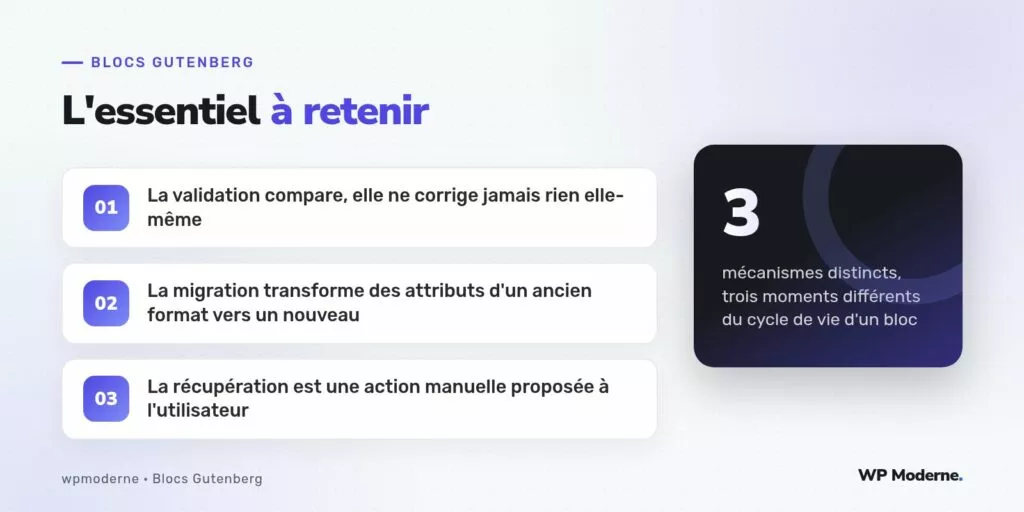
Ces trois mécanismes ne se remplacent jamais l’un l’autre : la validation constate, la migration transforme un format connu, la récupération est un pari accepté par un humain.
Ce que cette notion ne couvre pas en détail
La syntaxe complète du tableau deprecated, ses champs isEligible, et la mécanique fine de résolution parmi plusieurs entrées candidates ont déjà été traitées en profondeur ailleurs. Cet article se limite à distinguer les trois concepts entre eux, pas à détailler chacun exhaustivement.
Pour aller plus loin
Comprendre cette distinction change la façon d’aborder un incident : face à un bloc invalidé en masse, la première question n’est jamais « pourquoi la migration a-t-elle échoué », mais « la validation a-t-elle raison de signaler un écart, et cet écart correspond-il à une perte réelle de donnée ou à une simple différence de sérialisation ».